Gestion des incidents ITIL : priorité, incident majeur, escalade
Sommaire 13 parties
- Qu’est-ce que la gestion des incidents ?
- Les étapes de la gestion des incidents
- Prioriser : impact, urgence et priorité
- L’escalade : fonctionnelle et hiérarchique
- L’incident majeur
- Les modèles d’incidents et la base de connaissance
- Les indicateurs de la gestion des incidents
- Gestion des incidents et gestion des problèmes
- Le point de vue du responsable d’équipe
- La gestion des incidents dans ITIL 4 et ITIL 5
- Les erreurs fréquentes
- Questions fréquentes sur la gestion des incidents ITIL
- Sources
La gestion des incidents ITIL rétablit un service interrompu ou dégradé le plus vite possible, en limitant l’effet sur les utilisateurs. Elle enregistre chaque incident, lui donne une priorité selon son impact et son urgence, l’escalade si besoin, puis le résout et le clôt. C’est la pratique ITIL la plus répandue, et souvent la première que l’on met en place.
Les incidents rythment le quotidien de toute équipe d’exploitation. Dans ce guide, je vous explique ce que dit ITIL, étape par étape, avec une matrice de priorité, la procédure d’incident majeur illustrée par un scénario heure par heure, un modèle de message aux utilisateurs et les indicateurs qui comptent vraiment.
- Un incident est une interruption non planifiée d’un service, ou une baisse de sa qualité.
- L’objectif de la gestion des incidents est de rétablir le service au plus vite, même provisoirement. Trouver la cause relève de la gestion des problèmes.
- La priorité croise l’impact (combien d’utilisateurs, quel enjeu) et l’urgence (à quelle vitesse agir).
- L’escalade fonctionnelle confie l’incident à plus d’expertise, l’escalade hiérarchique mobilise la hiérarchie.
- Les incidents les plus graves suivent une procédure d’incident majeur : un responsable, une équipe dédiée, une communication régulière et une revue après coup.
Qu’est-ce que la gestion des incidents ?
Selon le glossaire ITIL, un incident est une interruption non planifiée d’un service informatique, ou une baisse de sa qualité. La panne d’un composant qui n’a pas encore touché le service compte aussi : un disque défaillant dans un serveur redondé, par exemple, est un incident, même si personne ne s’en est aperçu. La gestion des incidents est l’une des pratiques centrales du référentiel ITIL.
La gestion des incidents pilote le cycle de vie de tous les incidents. Elle veille à ce que le fonctionnement normal du service soit rétabli le plus vite possible, et que l’impact sur l’activité reste minimal. ITIL 4 le formule ainsi : réduire l’impact négatif des incidents en rétablissant le fonctionnement normal au plus vite.
Le mot clé est « rétablir ». Un incident est traité quand le service fonctionne à nouveau, même grâce à un contournement provisoire. Comprendre pourquoi il est tombé est le rôle de la gestion des problèmes.
Incident, demande, problème, événement : ne pas tout mélanger
| Notion | Ce que c’est | Exemple |
|---|---|---|
| Événement | Un changement d’état détecté, souvent par la supervision | Un disque rempli à 80 % |
| Incident | Une interruption ou une dégradation du service | L’ERP ne répond plus |
| Demande de service | Une demande courante et prévue, pas une panne | Un accès à une application |
| Problème | La cause d’un ou plusieurs incidents | Un défaut de configuration qui fait tomber l’ERP chaque mois |
Traiter les demandes comme des incidents fausse les statistiques et noie les vraies pannes. Le parcours complet, de l’alerte à la correction définitive, est illustré dans l’article sur l’exploitation des services.
Les étapes de la gestion des incidents
ITIL décrit un enchaînement d’étapes, du signalement à la clôture. Le schéma ci-dessous les résume.
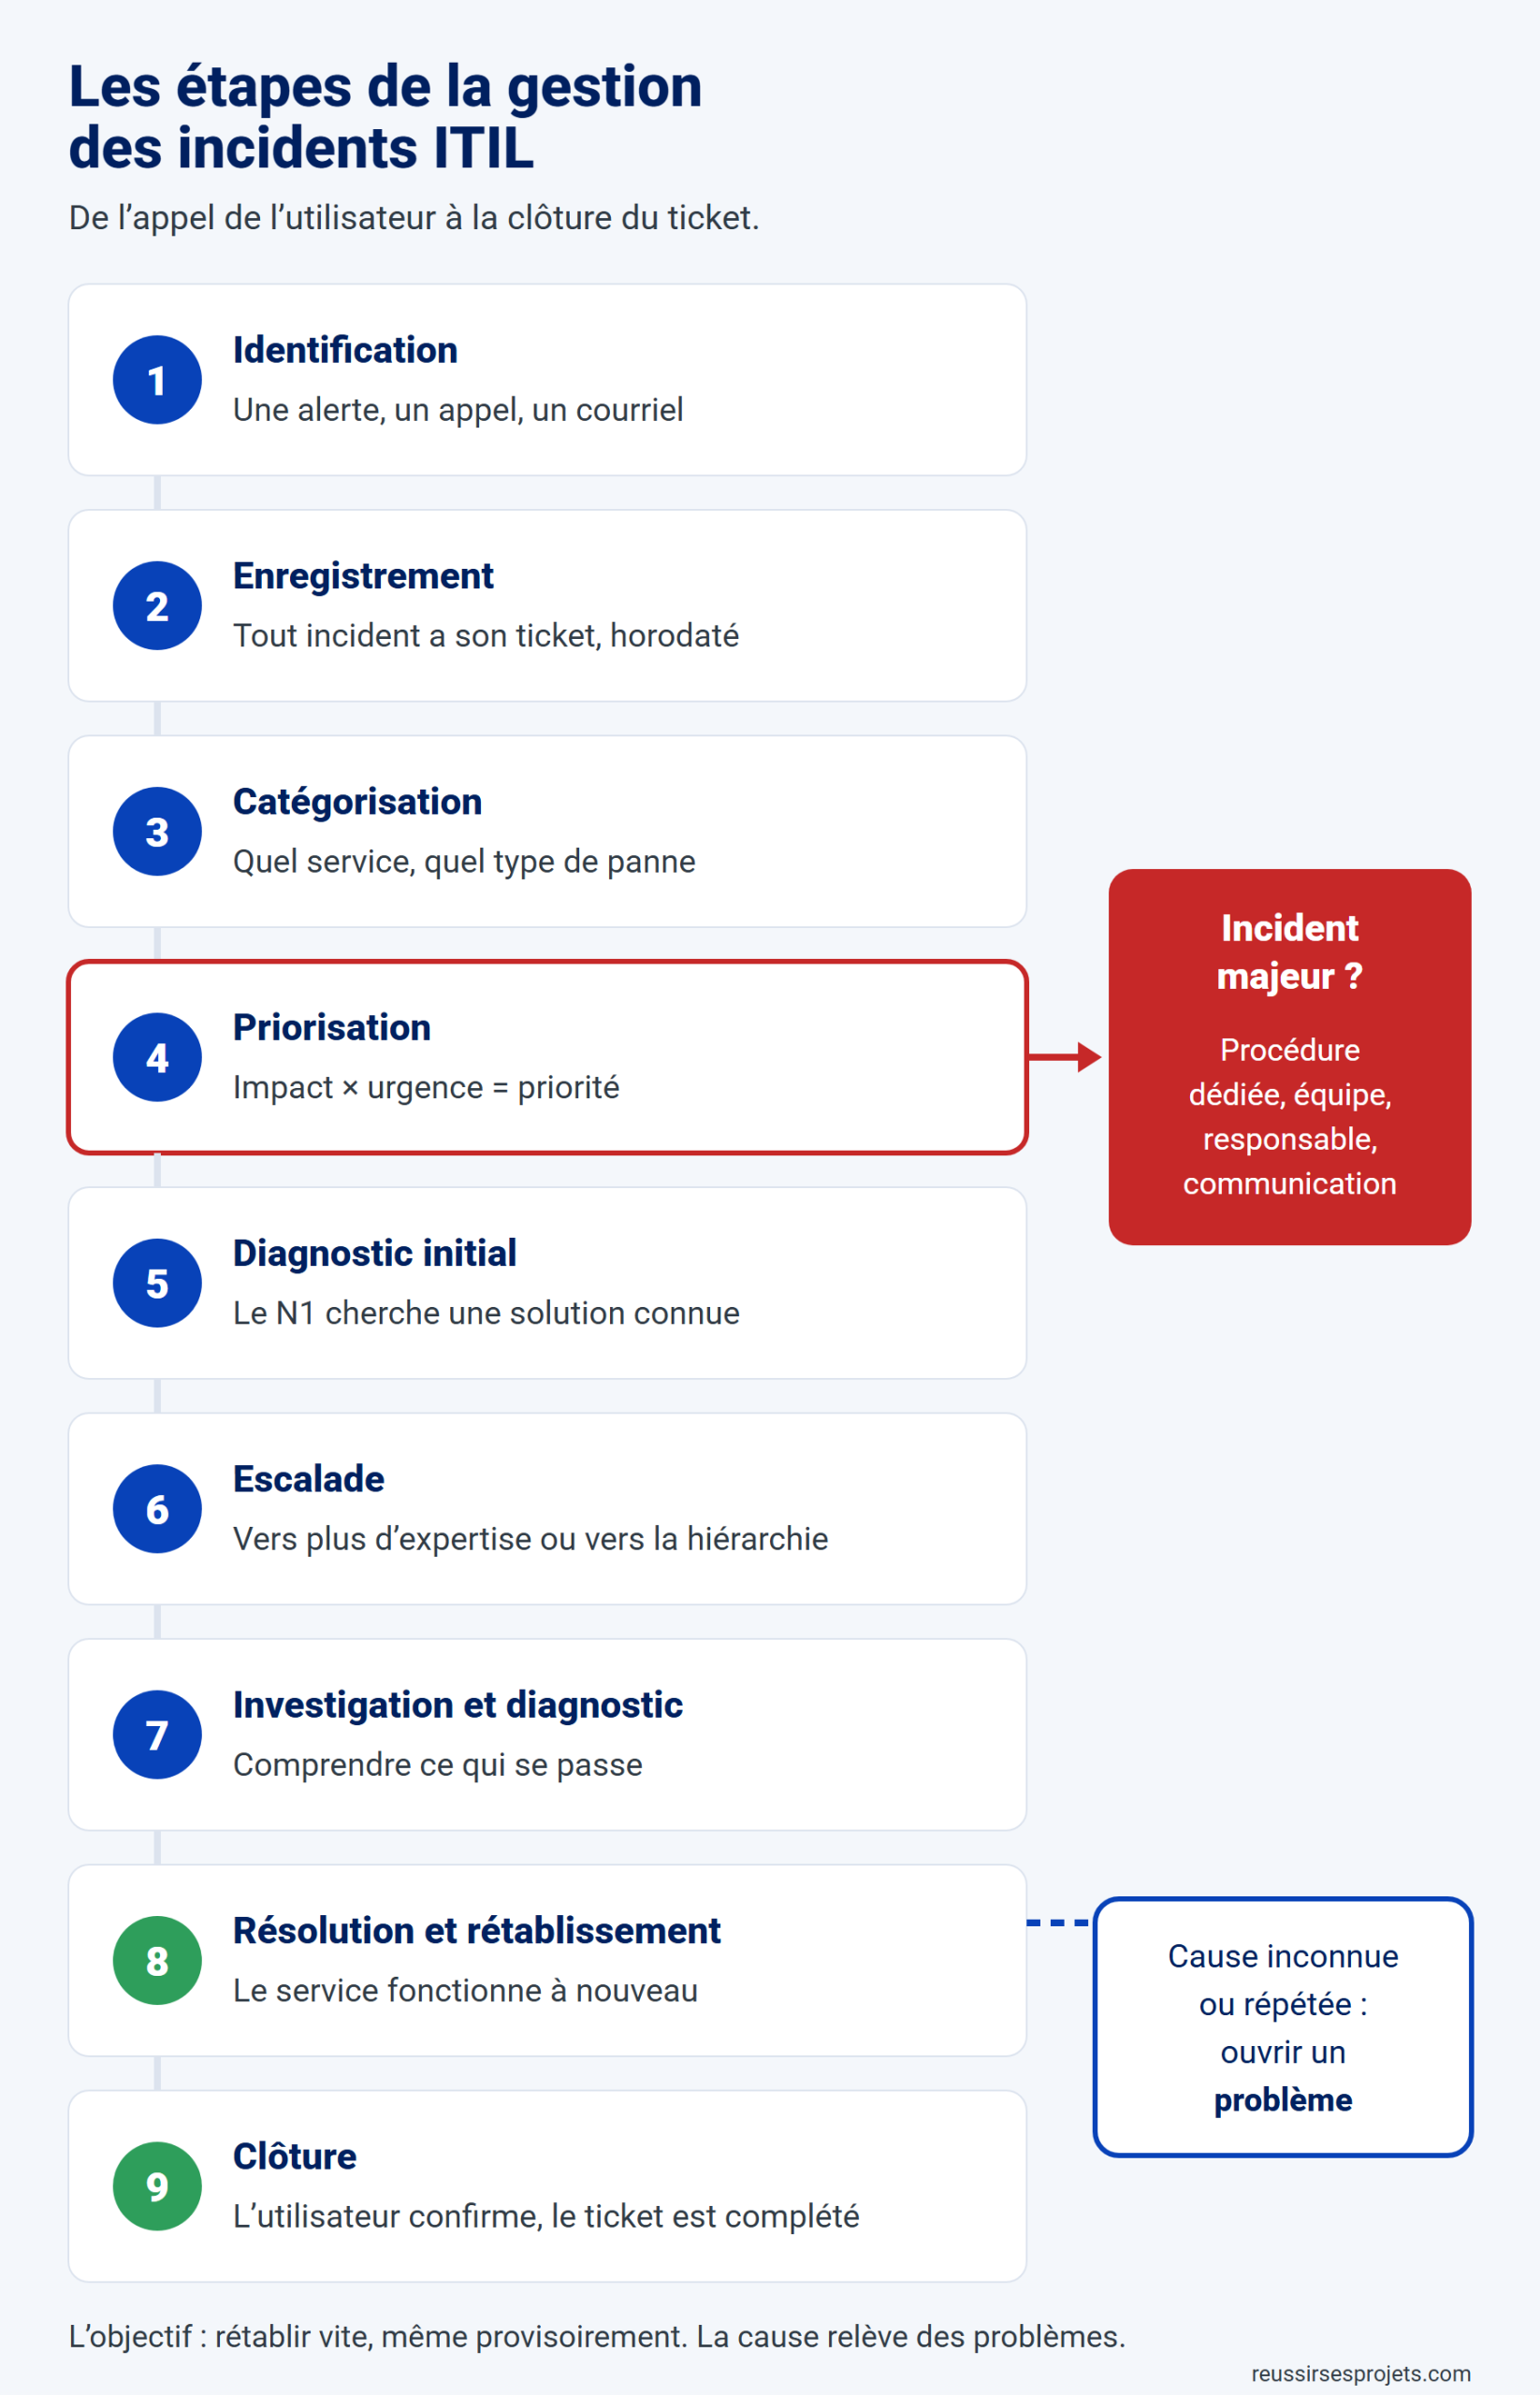
- Identification. L’incident est repéré : appel ou courriel d’un utilisateur, alerte de la supervision, signalement d’un technicien. Idéalement, la supervision le détecte avant les utilisateurs.
- Enregistrement. Chaque incident a son ticket, avec la date et l’heure, la personne qui le signale, les symptômes et le service concerné. Un incident non enregistré n’existe pas pour l’amélioration.
- Catégorisation. On le classe par service et par type de panne. C’est aussi le moment de vérifier qu’il ne s’agit pas d’une demande de service.
- Priorisation. On croise l’impact et l’urgence pour fixer la priorité, et donc le délai de traitement.
- Diagnostic initial. Le centre de services cherche une solution connue dans la base de connaissance et la liste des erreurs connues. S’il la trouve, il résout tout de suite.
- Escalade. Sinon, l’incident passe à une équipe plus spécialisée, et la hiérarchie est prévenue si la gravité l’exige.
- Investigation et diagnostic. Les experts analysent : que s’est-il passé, depuis quand, qu’est-ce qui a changé récemment ?
- Résolution et rétablissement. La solution ou le contournement est appliqué, puis on vérifie que le service fonctionne à nouveau.
- Clôture. On vérifie la catégorie, on interroge l’utilisateur, on complète le ticket et l’on se demande si l’incident risque de se reproduire. Si oui, on ouvre un problème.
Tout au long du parcours, le centre de services reste propriétaire de l’incident : même escaladé, c’est lui qui garde le lien avec l’utilisateur et veille à ce que le ticket avance. Prévoyez aussi une règle de réouverture : par exemple, si la même panne revient chez le même utilisateur dans la journée, on rouvre le ticket au lieu d’en créer un nouveau.
Prioriser : impact, urgence et priorité
Tous les incidents ne se valent pas. La priorité décide de l’ordre de traitement et des délais. Elle croise deux critères :
- l’impact : combien d’utilisateurs sont touchés, et quel est l’enjeu pour le métier
- l’urgence : à quelle vitesse l’incident doit être résolu pour limiter les dégâts.
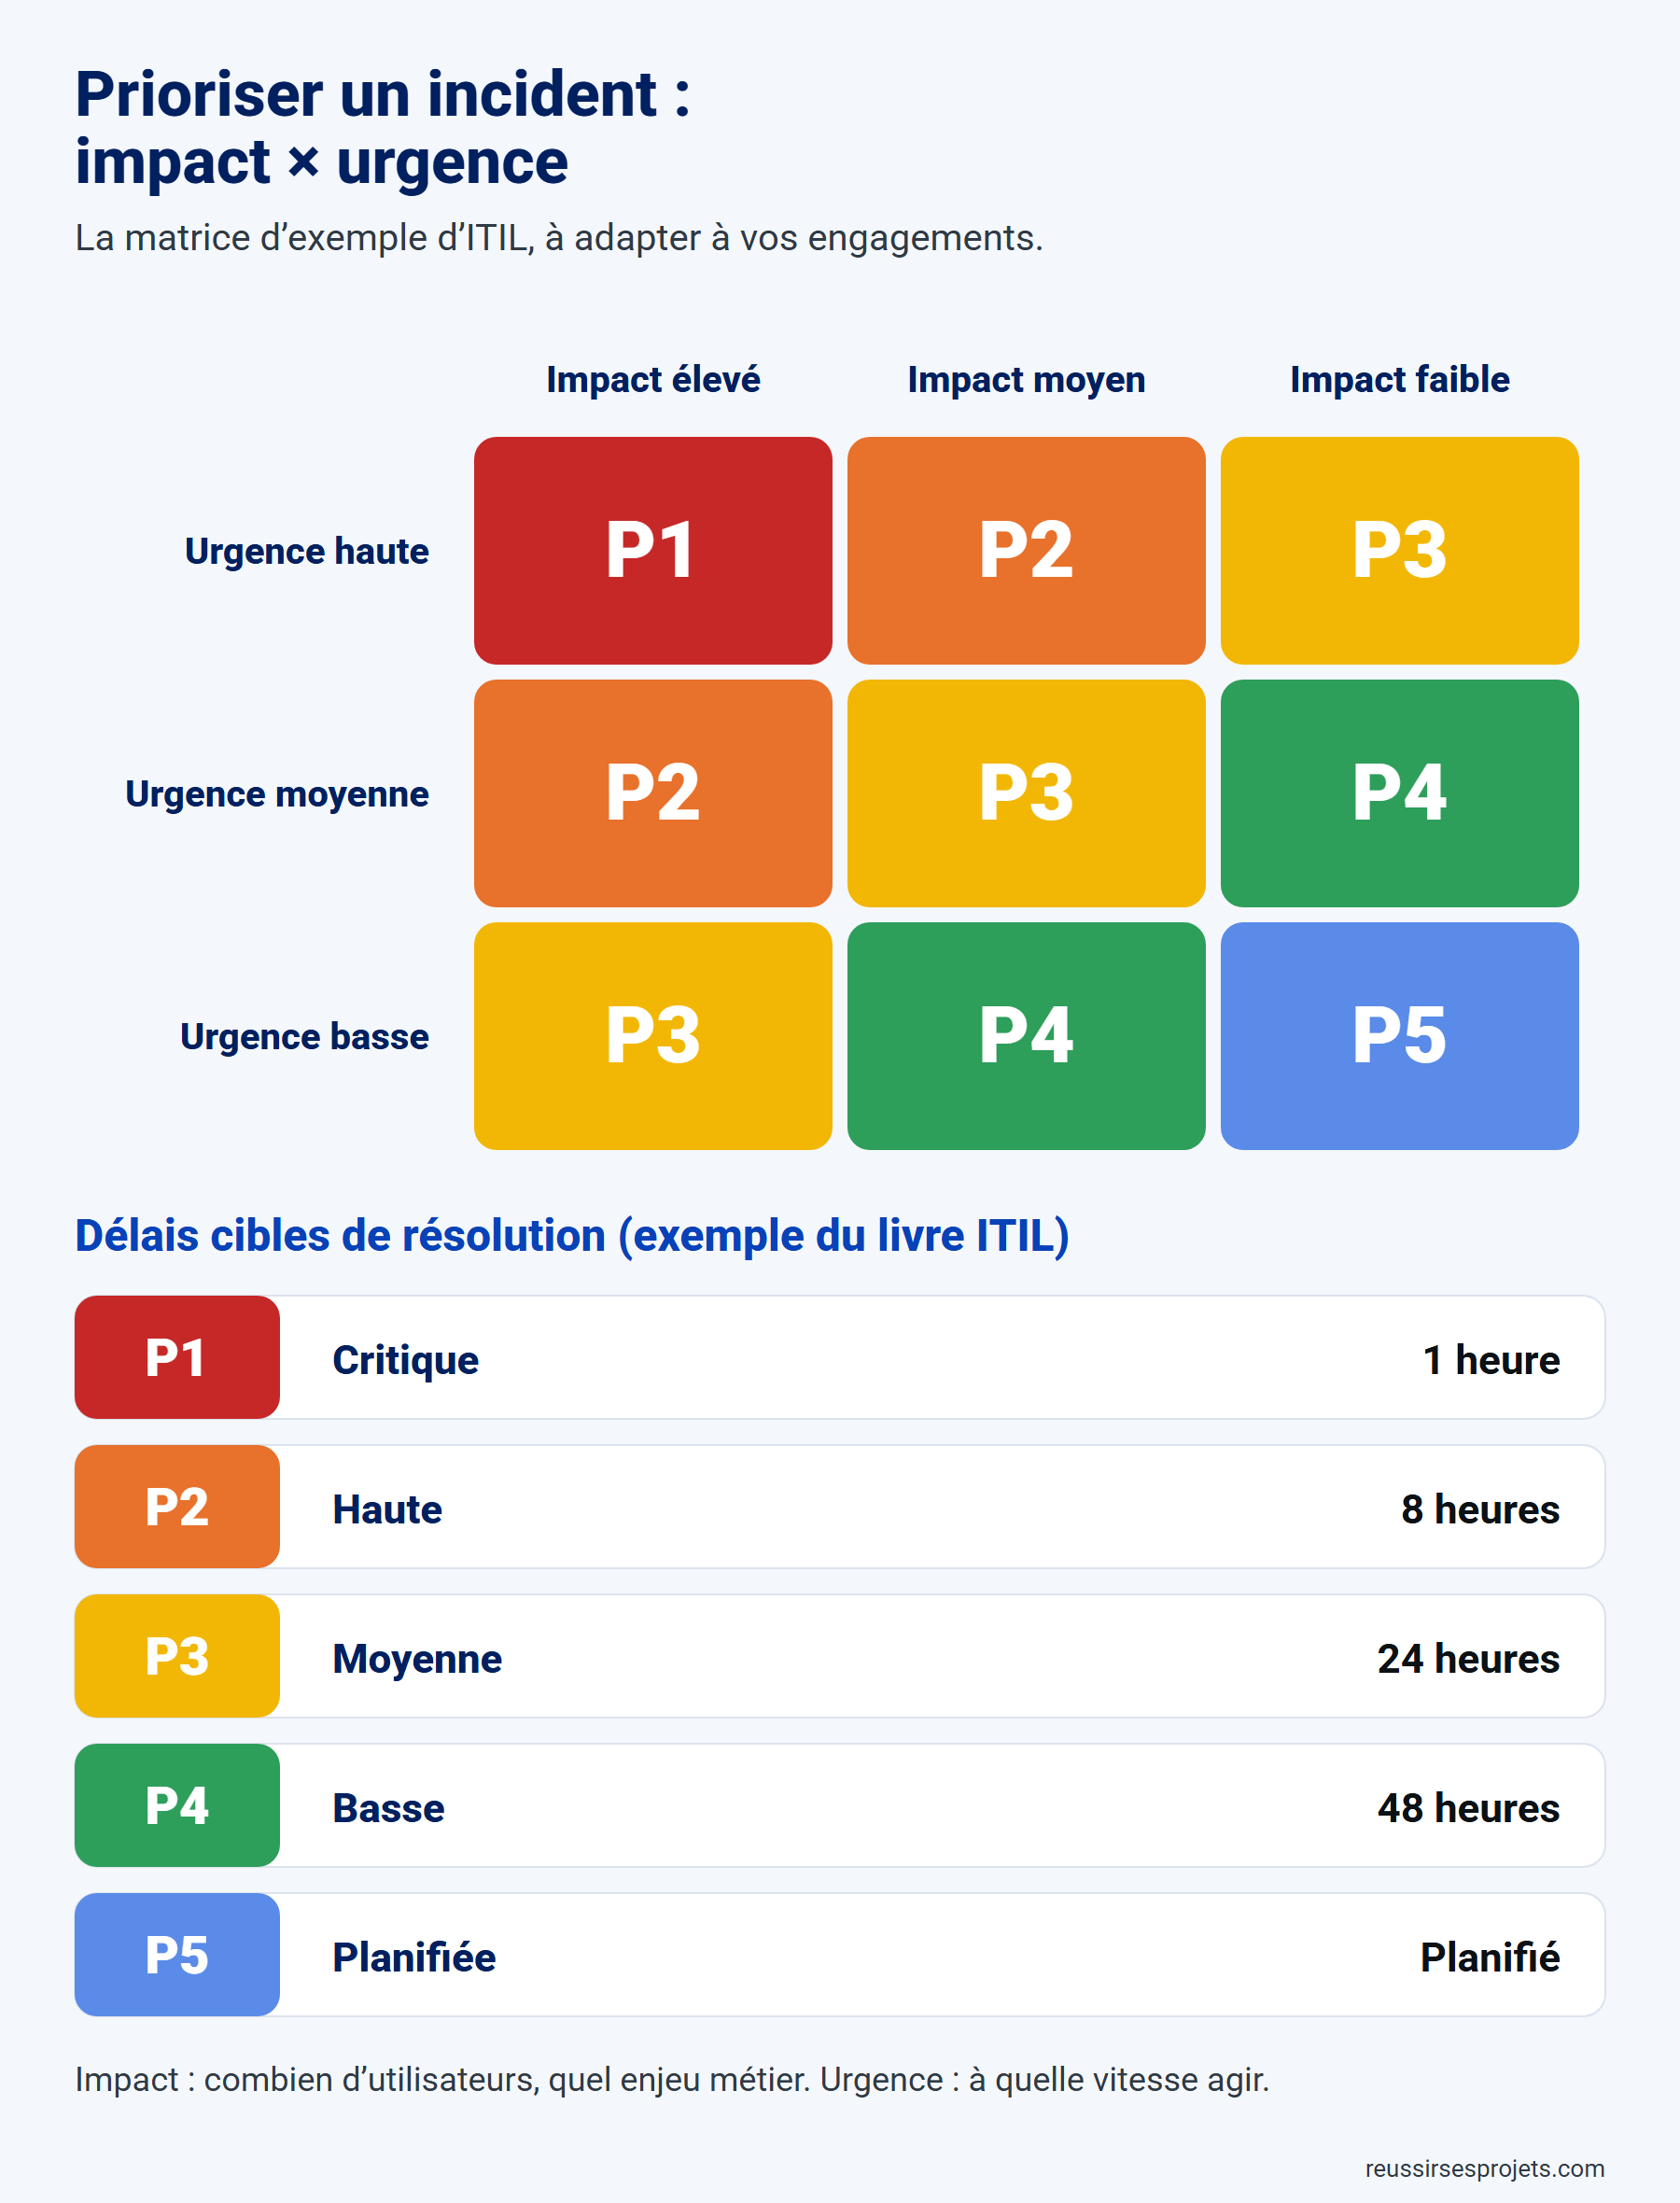
Le livre ITIL consacré à l’exploitation propose cet exemple de codification :
| Priorité | Libellé | Délai cible de résolution | Combinaisons impact et urgence |
|---|---|---|---|
| P1 | Critique | 1 heure | Impact élevé et urgence haute |
| P2 | Haute | 8 heures | Élevé et moyenne, ou moyen et haute |
| P3 | Moyenne | 24 heures | Élevé et basse, moyen et moyenne, ou faible et haute |
| P4 | Basse | 48 heures | Moyen et basse, ou faible et moyenne |
| P5 | Planifiée | Planifié | Impact faible et urgence basse |
Ces délais sont un exemple, à caler sur vos engagements de niveau de service et sur vos plages horaires. Pour évaluer l’impact, ITIL cite plusieurs facteurs : le risque pour les personnes, le nombre de services et d’utilisateurs touchés, les pertes financières, l’atteinte à la réputation et les risques réglementaires. La priorité n’est pas figée : elle peut monter si la situation s’aggrave, ou si l’utilisateur explique un enjeu que l’on ne connaissait pas.
L’escalade : fonctionnelle et hiérarchique
Quand le premier niveau ne peut pas résoudre, l’incident est escaladé. ITIL distingue deux escalades, qui peuvent avoir lieu en même temps :
- l’escalade fonctionnelle transfère l’incident à une équipe plus spécialisée, ou qui dispose de plus de temps ou d’accès : du centre de services (N1) vers une équipe technique (N2), puis vers un expert ou un éditeur (N3)
- l’escalade hiérarchique informe ou mobilise la hiérarchie, parce que l’incident est grave, que le délai promis risque d’être dépassé, ou qu’une décision dépasse l’équipe.
Pour que l’escalade ne dépende pas de l’humeur du moment, fixez des déclencheurs écrits. Par exemple :
- escalade fonctionnelle dès que le N1 n’a pas de solution connue après 20 minutes, ou qu’il lui manque un accès ou une compétence
- escalade hiérarchique quand la moitié du délai de résolution promis est consommée sans piste sérieuse
- escalade hiérarchique immédiate pour tout incident qui touche un site entier ou une fonction métier vitale.
Le passage de relais est souvent le moment où l’on perd le plus de temps : le ticket attend dans une file, l’expert redemande ce que le N1 a déjà fait. Un ticket complet, avec les essais réalisés et leur résultat, fait gagner de précieuses minutes. L’organisation du support en niveaux est détaillée dans l’article sur l’exploitation des services.
L’incident majeur
Selon le glossaire ITIL, l’incident majeur est la catégorie d’impact la plus élevée : il perturbe fortement l’activité. ITIL demande de le traiter avec une procédure distincte, des délais plus courts et une plus grande urgence. Ses traits principaux :
- une équipe dédiée, réunie sous la conduite directe du responsable de la gestion des incidents, ou d’une personne qui lui rend compte
- une séparation nette entre le rétablissement du service et la recherche de la cause, qui peut être menée en parallèle par la gestion des problèmes
- un suivi rigoureux : le centre de services enregistre toutes les actions et tient les utilisateurs informés.
Les critères qui font d’un incident un incident majeur doivent être écrits à l’avance et alignés sur la matrice de priorité. Le jour J, personne ne doit hésiter à déclarer. Voici à quoi ressemble un incident majeur bien conduit, sur un scénario fictif.
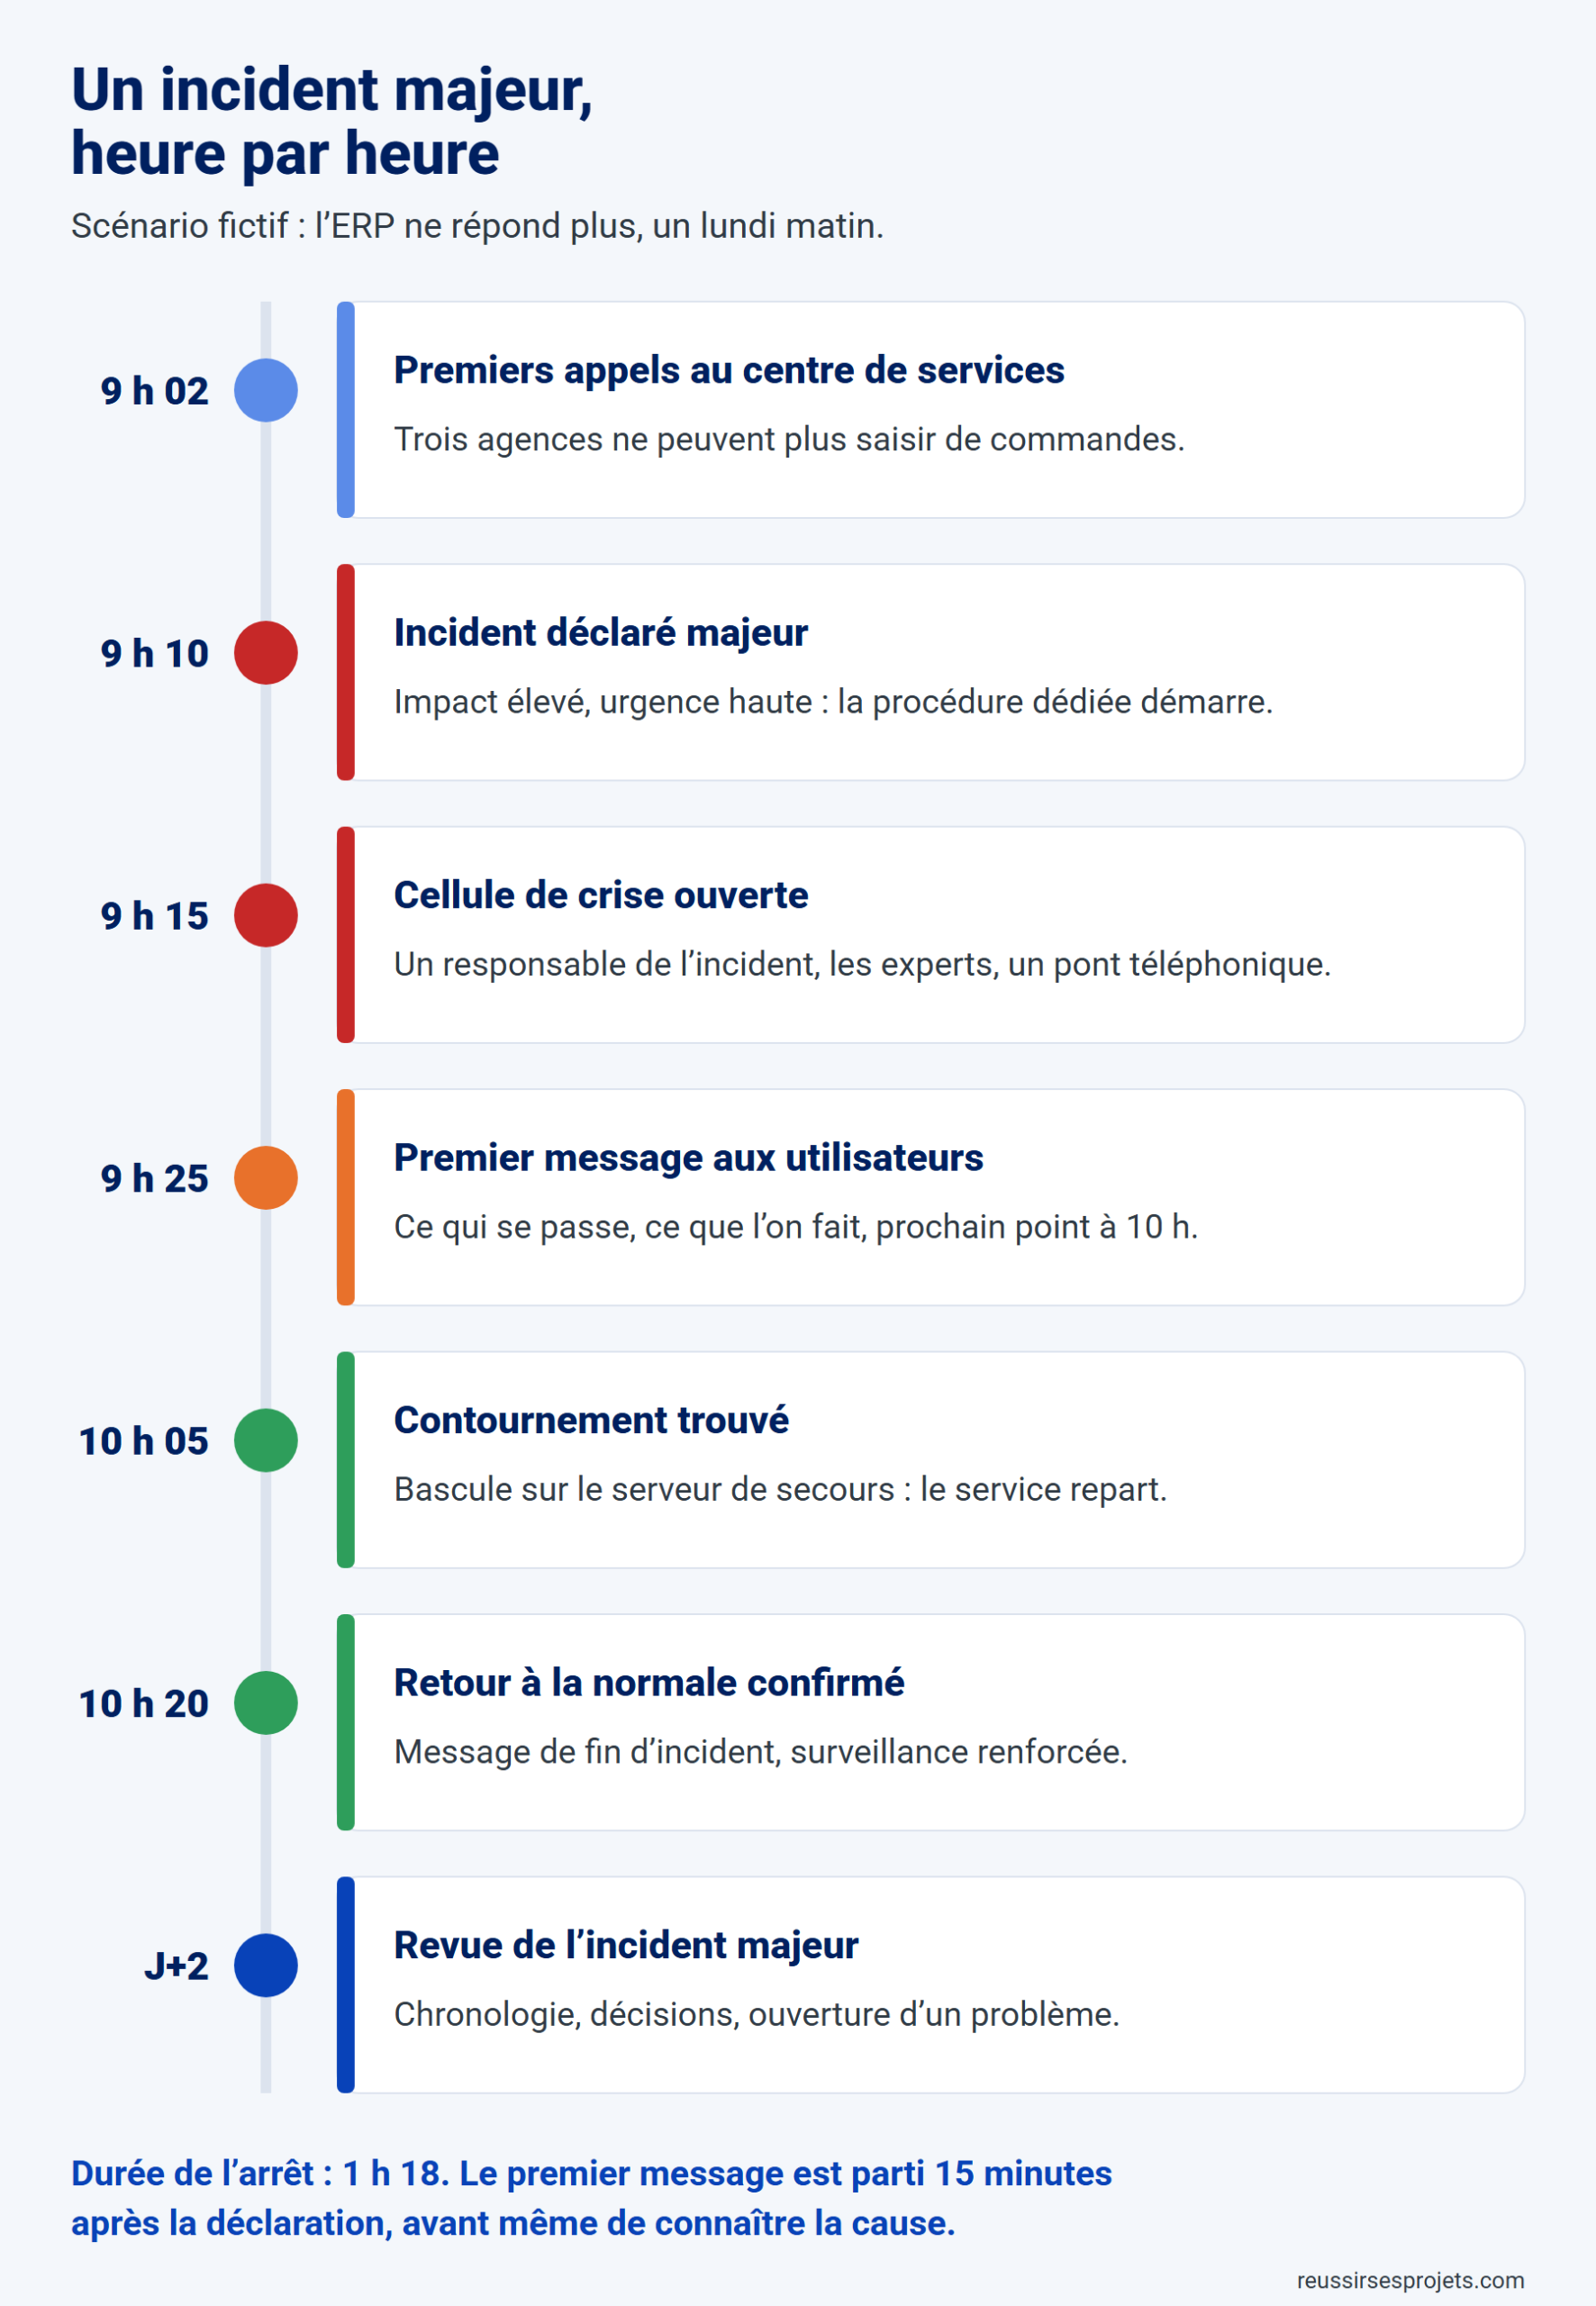
La check-list d’un incident majeur
- Déclarer l’incident majeur sans attendre, sur des critères écrits à l’avance.
- Désigner un responsable de l’incident, qui coordonne et ne répare pas lui-même.
- Réunir les bonnes personnes dans un même canal : pont téléphonique, salon de discussion.
- Envoyer un premier message aux utilisateurs dans le quart d’heure, même sans la cause.
- Fixer l’heure du prochain point d’information, et la tenir.
- Noter au fil de l’eau les actions, les décisions et les heures.
- Chercher un contournement en priorité, la cause viendra après.
- Annoncer la fin de l’incident, puis surveiller de près pendant quelques heures.
- Tenir une revue dans les jours qui suivent, et ouvrir un problème.
Un modèle de message aux utilisateurs
Objet : incident en cours sur l’ERP
Depuis 9 h 02, la saisie des commandes est impossible dans l’ERP pour l’ensemble des agences. Nos équipes sont mobilisées pour rétablir le service au plus vite. En attendant, notez les commandes urgentes sur le formulaire de secours habituel.
Prochain point d’information : 10 h, même sans changement.
Le centre de services
Un bon message dit ce qui ne marche pas, depuis quand, ce que l’on fait, ce que l’utilisateur peut faire en attendant et quand viendra la prochaine information. Il évite le jargon et les promesses d’heure de retour que l’on n’est pas sûr de tenir.
La revue de l’incident majeur
Quelques jours après, l’équipe reprend la chronologie, sans chercher de coupable : qu’est-ce qui a bien fonctionné, qu’est-ce qui a ralenti, quelles décisions prendre ? Les actions vont dans le registre d’amélioration continue, et la recherche de la cause dans la gestion des problèmes. C’est le même esprit qu’un retour d’expérience projet.
Les modèles d’incidents et la base de connaissance
Beaucoup d’incidents se ressemblent : mot de passe bloqué, imprimante hors ligne, lenteur d’une application connue. Pour eux, ITIL recommande des modèles d’incidents : une procédure prédéfinie, qui dit qui fait quoi, dans quel ordre et dans quels délais. Ils s’appuient sur la base de connaissance et sur la liste des erreurs connues, alimentée par la gestion des problèmes.
Ce sont eux qui font grimper le taux de résolution au premier contact. Chaque incident résolu par un expert pour une question déjà vue cent fois est un modèle ou un article de connaissance qui manque.
Les indicateurs de la gestion des incidents
Le livre ITIL sur l’exploitation cite une quinzaine d’indicateurs possibles. Voici ceux que je recommande de suivre en priorité :
| Indicateur | Ce qu’il montre |
|---|---|
| Temps moyen de résolution ou de contournement, par priorité | La rapidité réelle, là où elle compte |
| Part des incidents traités dans le délai convenu | Le respect des engagements |
| Part des incidents résolus par le centre de services, sans escalade | L’efficacité du premier niveau et de la base de connaissance |
| Nombre et part des incidents majeurs | La gravité des pannes et leur tendance |
| Nombre et part des incidents rouverts | La qualité des résolutions |
| Part des incidents mal catégorisés ou mal attribués | La qualité du tri, qui conditionne tout le reste |
| Nombre d’incidents en attente | La charge et les risques de retard |
Gestion des incidents et gestion des problèmes
La gestion des incidents rétablit, la gestion des problèmes supprime la cause. Les deux travaillent ensemble : les incidents répétés ou graves déclenchent un problème, et la gestion des problèmes fournit en retour des contournements et des erreurs connues qui accélèrent la résolution des incidents suivants. Un incident ne devient jamais un problème : les deux sont enregistrés à part, puis reliés.
Pour trouver une cause, des techniques simples suffisent souvent, comme la méthode des 5 pourquoi. La correction définitive passe ensuite par un changement, décrit dans l’article sur la transition des services.
Le point de vue du responsable d’équipe
Dans une équipe technique, les incidents et les projets se disputent les mêmes personnes. Un expert qui passe sa matinée sur un incident ne fait pas avancer son projet. Trois habitudes aident à tenir les deux :
- désigner chaque semaine qui assure le niveau 2, pour que les autres puissent se concentrer sur leurs projets
- compter le temps passé sur les incidents, et le montrer en comité de pilotage quand il menace un planning
- protéger l’équipe pendant un incident majeur : le responsable de l’incident répond aux questions, les experts réparent.
Côté projet, ce temps doit être prévu. Une équipe qui assure le support ne peut pas être planifiée à 100 % sur un projet, comme le rappellent les risques les plus courants d’un projet.
La gestion des incidents dans ITIL 4 et ITIL 5
Dans ITIL 4, la gestion des incidents est une pratique de gestion des services. Les principes restent ceux de la v3 : prioriser selon une classification convenue pour traiter d’abord les incidents qui touchent le plus l’activité, orienter les tickets selon leur catégorie, et rapprocher automatiquement les incidents des problèmes et des erreurs connues.
ITIL 4 ajoute deux idées utiles :
- le swarming (« essaimage ») : plutôt que de faire passer un incident de niveau en niveau, plusieurs personnes compétentes travaillent ensemble dès le départ, jusqu’à ce que l’on sache qui est le mieux placé pour continuer. Les autres retournent alors à leurs tâches.
- les équipes temporaires : les incidents les plus complexes, et tous les incidents majeurs, réunissent souvent une équipe le temps de trouver la solution.
En 2023, PeopleCert a publié une nouvelle version de la pratique, dans une première série de cinq pratiques révisées avec la gestion des problèmes, des demandes de service, des événements et le centre de services. Elle insiste sur le point de vue de l’utilisateur du service, plutôt que sur le seul respect des engagements contractuels.
ITIL 5, publié en 2026, conserve la pratique de gestion des incidents parmi ses 34 pratiques. Elle fait partie, avec le centre de services et la gestion des problèmes, du module de certification « Monitor, Support and Fulfil ».
Les erreurs fréquentes
- Tout classer en priorité haute. La priorité ne joue plus son rôle, et les vrais incidents graves attendent.
- Chercher la cause avant de rétablir. Un contournement en dix minutes vaut mieux qu’un diagnostic parfait en deux heures.
- Oublier de communiquer. Pendant un incident majeur, le silence génère plus d’appels que la panne elle-même.
- Clore sans l’utilisateur. Le ticket est fermé, mais le problème de l’utilisateur n’est pas réglé.
- Ne jamais analyser les incidents répétés. Les mêmes pannes reviennent, et l’équipe s’épuise à les réparer.
Questions fréquentes sur la gestion des incidents ITIL
Qu’est-ce qu’un incident en ITIL ?
C’est une interruption non planifiée d’un service, ou une baisse de sa qualité. La panne d’un composant qui n’a pas encore touché les utilisateurs, comme un disque défaillant dans un serveur redondé, est aussi un incident.
Comment définir la priorité d’un incident ?
On croise son impact, c’est-à-dire le nombre d’utilisateurs touchés et l’enjeu métier, et son urgence, c’est-à-dire la vitesse à laquelle il faut agir. Une matrice à trois niveaux pour chacun donne en général cinq priorités, de critique à planifiée.
Qu’est-ce qu’un incident majeur ?
C’est un incident dont l’impact sur l’activité est le plus élevé. Il suit une procédure distincte : un responsable désigné, une équipe dédiée, des délais plus courts, une communication régulière et une revue après coup.
Quelle différence entre escalade fonctionnelle et hiérarchique ?
L’escalade fonctionnelle confie l’incident à une équipe plus spécialisée. L’escalade hiérarchique informe ou mobilise la hiérarchie, parce que l’incident est grave ou qu’un délai risque d’être dépassé.
Quelle différence entre un incident et un problème ?
L’incident est l’interruption du service : on le rétablit vite. Le problème est la cause d’un ou plusieurs incidents : on la cherche, puis on la supprime.
Qu’est-ce que le swarming ?
C’est une technique décrite par ITIL 4 : au lieu d’escalader un incident de niveau en niveau, on réunit d’emblée plusieurs personnes compétentes, qui travaillent ensemble jusqu’à savoir qui doit poursuivre. Elle réduit les allers-retours entre équipes, au prix d’une mobilisation plus large au départ.
Qui peut clore un incident ?
En général, le centre de services, après avoir vérifié avec l’utilisateur que le service fonctionne à nouveau pour lui. Une équipe technique peut résoudre l’incident, mais la clôture revient à celui qui garde la relation avec l’utilisateur. Beaucoup d’outils clôturent automatiquement un ticket résolu sans réponse après quelques jours.
Sources
- Glossaire officiel ITIL 2011, entrées incident, incident management, impact, urgency, priority, major incident, escalation, functional escalation, hierarchic escalation, workaround, service desk (Crown Copyright 2011).
- ITIL Service Operation, édition 2007 : étapes du processus (section 4.2.5), codification des priorités (tableau 4.1), incidents majeurs (section 4.2.4.3), indicateurs (section 4.2.8).
- AXELOS, Introductory Overview of ITIL 4 (2020).
- PeopleCert, ITIL 4 Management Practices 2023.
- PeopleCert, questions fréquentes sur ITIL (Version 5).

Thibault Baheux
Expert en pilotage de projets IT & transformations complexes
Responsable de pôle infrastructure IT, auteur et fondateur de Réussir Ses Projets, je manage 15 personnes en direct et je pilote un portefeuille de projets.
Depuis 2008, je suis passé de l'administration système à la direction de projet. Depuis 2020, je transmets sur ce site des méthodes nées du terrain, à travers des articles, des livres, des outils et des formations.
Certifications