Gestion de la disponibilité ITIL : calcul, MTBF, 99,9 %
Sommaire 13 parties
- Qu’est-ce que la gestion de la disponibilité ?
- Les notions à connaître
- Calculer la disponibilité
- MTBF, MTRS, MTBSI : mesurer fiabilité et rétablissement
- Le cycle de vie étendu de l’incident
- Les activités et les techniques
- La disponibilité vue par l’utilisateur
- Écrire un engagement de disponibilité qui tienne
- Disponibilité et chef de projet
- Les erreurs fréquentes
- La disponibilité dans ITIL 4 et ITIL 5
- Questions fréquentes sur la gestion de la disponibilité
- Sources
La gestion de la disponibilité ITIL s’assure qu’un service informatique fonctionne quand les utilisateurs en ont besoin, au niveau promis. Elle repose sur une formule simple, quelques indicateurs (MTBF, MTRS, MTBSI) et beaucoup de bon sens dans la conception des architectures. Elle fait partie de la conception des services dans ITIL v3, et devient une pratique de gestion des services dans ITIL 4.
Je dirige un pôle infrastructure IT, et la disponibilité est le chiffre que l’on me demande le plus souvent. Ce guide explique comment la calculer correctement, ce que valent vraiment 99,9 %, comment combiner plusieurs composants et comment écrire un engagement de disponibilité qui tienne.
- La disponibilité est la capacité d’un service à remplir sa fonction quand c’est prévu. On l’exprime en pourcentage du temps de service convenu.
- Formule : (temps de service convenu − temps d’indisponibilité) ÷ temps de service convenu × 100.
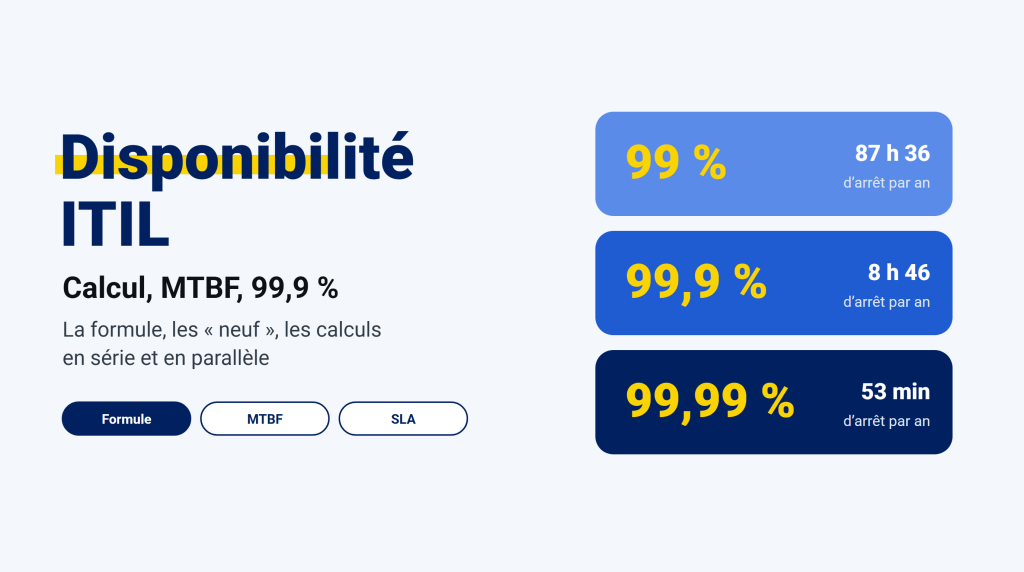
- 99,9 % en 24 h/24 représentent environ 8 h 46 d’arrêt par an, soit 44 minutes par mois.
- Le MTBF mesure la fiabilité, le MTRS la rapidité à rétablir, et le MTBSI est la somme des deux.
- Des composants en série se multiplient et font baisser la disponibilité. Des composants en parallèle la font monter.
Qu’est-ce que la gestion de la disponibilité ?
La gestion de la disponibilité vérifie que les services informatiques atteignent la disponibilité convenue avec les métiers, aujourd’hui et demain, pour un coût raisonnable. Elle conçoit, mesure et améliore. Elle ne se contente pas de compter les pannes : elle cherche à les éviter et à en réduire l’effet.
Dans ITIL v3, c’est l’un des 8 processus de la conception des services. Dans ITIL 4, c’est l’une des 17 pratiques de gestion des services, présentées dans l’article sur les processus et pratiques ITIL.
Disponibilité, capacité, continuité : trois sujets voisins
Les trois se confondent souvent. Ils répondent pourtant à des questions différentes :
| Sujet | Question | Exemple de réponse |
|---|---|---|
| Disponibilité | Le service fonctionne-t-il quand c’est prévu ? | Deux serveurs pour qu’une panne n’arrête pas le service |
| Capacité et performances | Tient-il la charge, avec des temps de réponse corrects ? | Un dimensionnement pour le pic de fin de mois |
| Continuité | Redémarre-t-il après un sinistre majeur ? | Un second site et un plan de reprise testé |
Un service lent au point d’être inutilisable est-il disponible ? Techniquement oui, pour l’utilisateur non. C’est pourquoi l’engagement de disponibilité doit dire ce que « fonctionner » veut dire.
Les notions à connaître
ITIL définit précisément le vocabulaire de la disponibilité. Ces définitions évitent bien des malentendus en comité de suivi.
| Notion | Définition simple | Comment on la mesure |
|---|---|---|
| Disponibilité | Capacité d’un service à remplir sa fonction convenue quand on en a besoin | Pourcentage du temps de service convenu |
| Fiabilité | Durée pendant laquelle un service fonctionne sans interruption | MTBF ou MTBSI |
| Maintenabilité | Rapidité avec laquelle on remet un service en état de marche après une panne | MTRS |
| Serviceabilité | Capacité d’un fournisseur à tenir ses engagements contractuels de fiabilité, de maintenabilité et de disponibilité | Respect des clauses du contrat |
| Résilience | Capacité à résister à une panne, ou à s’en remettre très vite | Effet réel des pannes sur le service |
| Temps de service convenu | Plage pendant laquelle le service doit être disponible, écrite dans le SLA | Heures et jours |
| Indisponibilité | Temps pendant lequel le service ne fonctionne pas, pendant le temps de service convenu | Heures et minutes |
| Fonction métier vitale | Partie d’un processus métier critique pour l’entreprise | Identifiée avec les métiers |
La disponibilité dépend donc de la fiabilité (les pannes sont-elles rares ?), de la maintenabilité (sont-elles vite réparées ?) et de la serviceabilité des fournisseurs (tiennent-ils leurs délais ?). ITIL recommande aussi de la mesurer, quand c’est possible, à partir de ce que produit le métier : des commandes saisies, des dossiers traités, plutôt que des serveurs allumés.
Calculer la disponibilité
ITIL calcule la disponibilité sur le temps de service convenu, c’est-à-dire la plage pendant laquelle le service doit fonctionner :
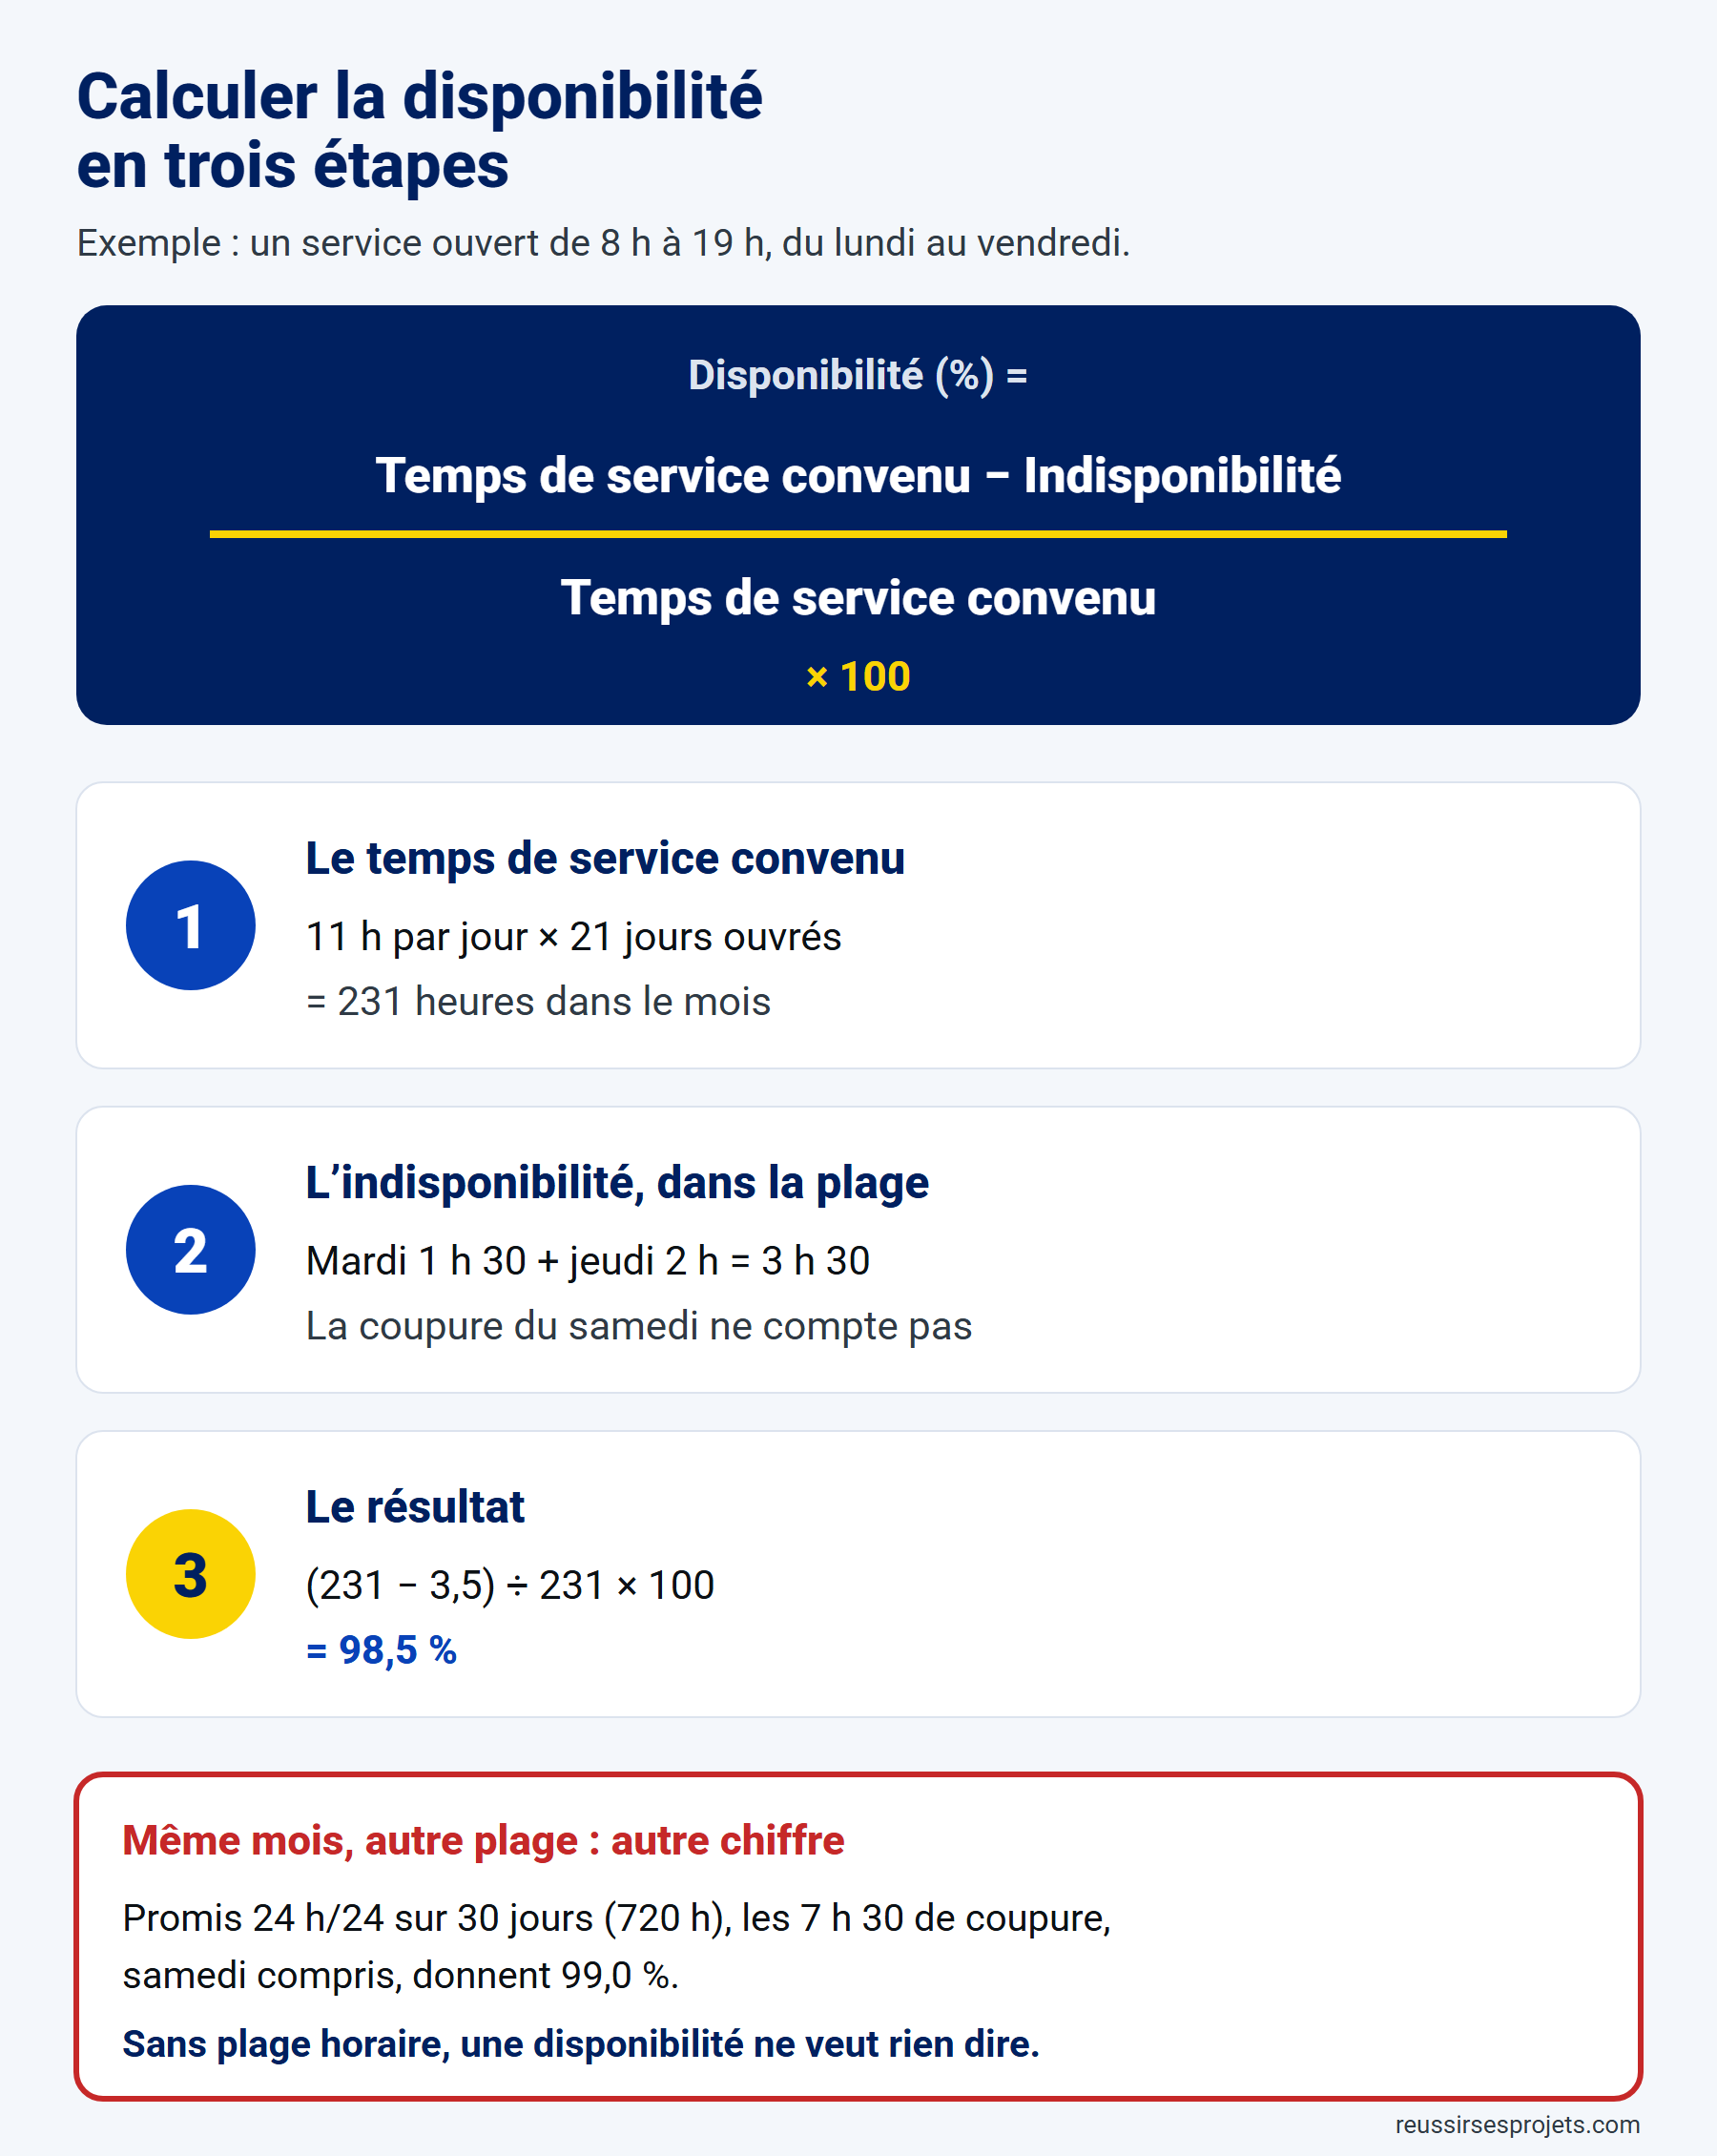
Disponibilité (%) = (temps de service convenu − temps d’indisponibilité) ÷ temps de service convenu × 100
Un exemple avec une plage horaire
Un service de gestion commerciale est ouvert du lundi au vendredi, de 8 h à 19 h, soit 11 heures par jour et 55 heures par semaine. Sur un mois de 21 jours ouvrés, le temps de service convenu est de 231 heures.
Ce mois-là, le service a subi deux pannes pendant la plage : 1 h 30 un mardi matin et 2 h un jeudi après-midi. Une troisième coupure de 4 heures a eu lieu un samedi, hors plage.
- Indisponibilité comptée : 1,5 + 2 = 3,5 heures. La coupure du samedi ne compte pas, puisqu’elle est hors du temps de service convenu.
- Disponibilité : (231 − 3,5) ÷ 231 × 100, soit environ 98,5 %.
Si le même service avait été promis 24 h/24 sur 30 jours, soit 720 heures, les 7 h 30 de coupure auraient donné 99,0 %. Le même mois peut donc afficher deux chiffres très différents selon la plage retenue. D’où la règle : une disponibilité sans plage horaire ne veut rien dire.
Le tableau des « neuf »
On parle souvent de « deux neuf », « trois neuf » ou « quatre neuf ». Voici ce que représentent ces chiffres pour un service ouvert 24 h/24, 7 j/7, sur une année de 365 jours :
| Disponibilité | Arrêt toléré par an | Par mois | Par semaine |
|---|---|---|---|
| 99 % (« deux neuf ») | 87 h 36 min | 7 h 18 min | 1 h 41 min |
| 99,5 % | 43 h 48 min | 3 h 39 min | 50 min |
| 99,9 % (« trois neuf ») | 8 h 46 min | 44 min | 10 min |
| 99,95 % | 4 h 23 min | 22 min | 5 min |
| 99,99 % (« quatre neuf ») | 53 min | 4 min 23 s | 1 min |
| 99,999 % (« cinq neuf ») | 5 min 15 s | 26 s | 6 s |
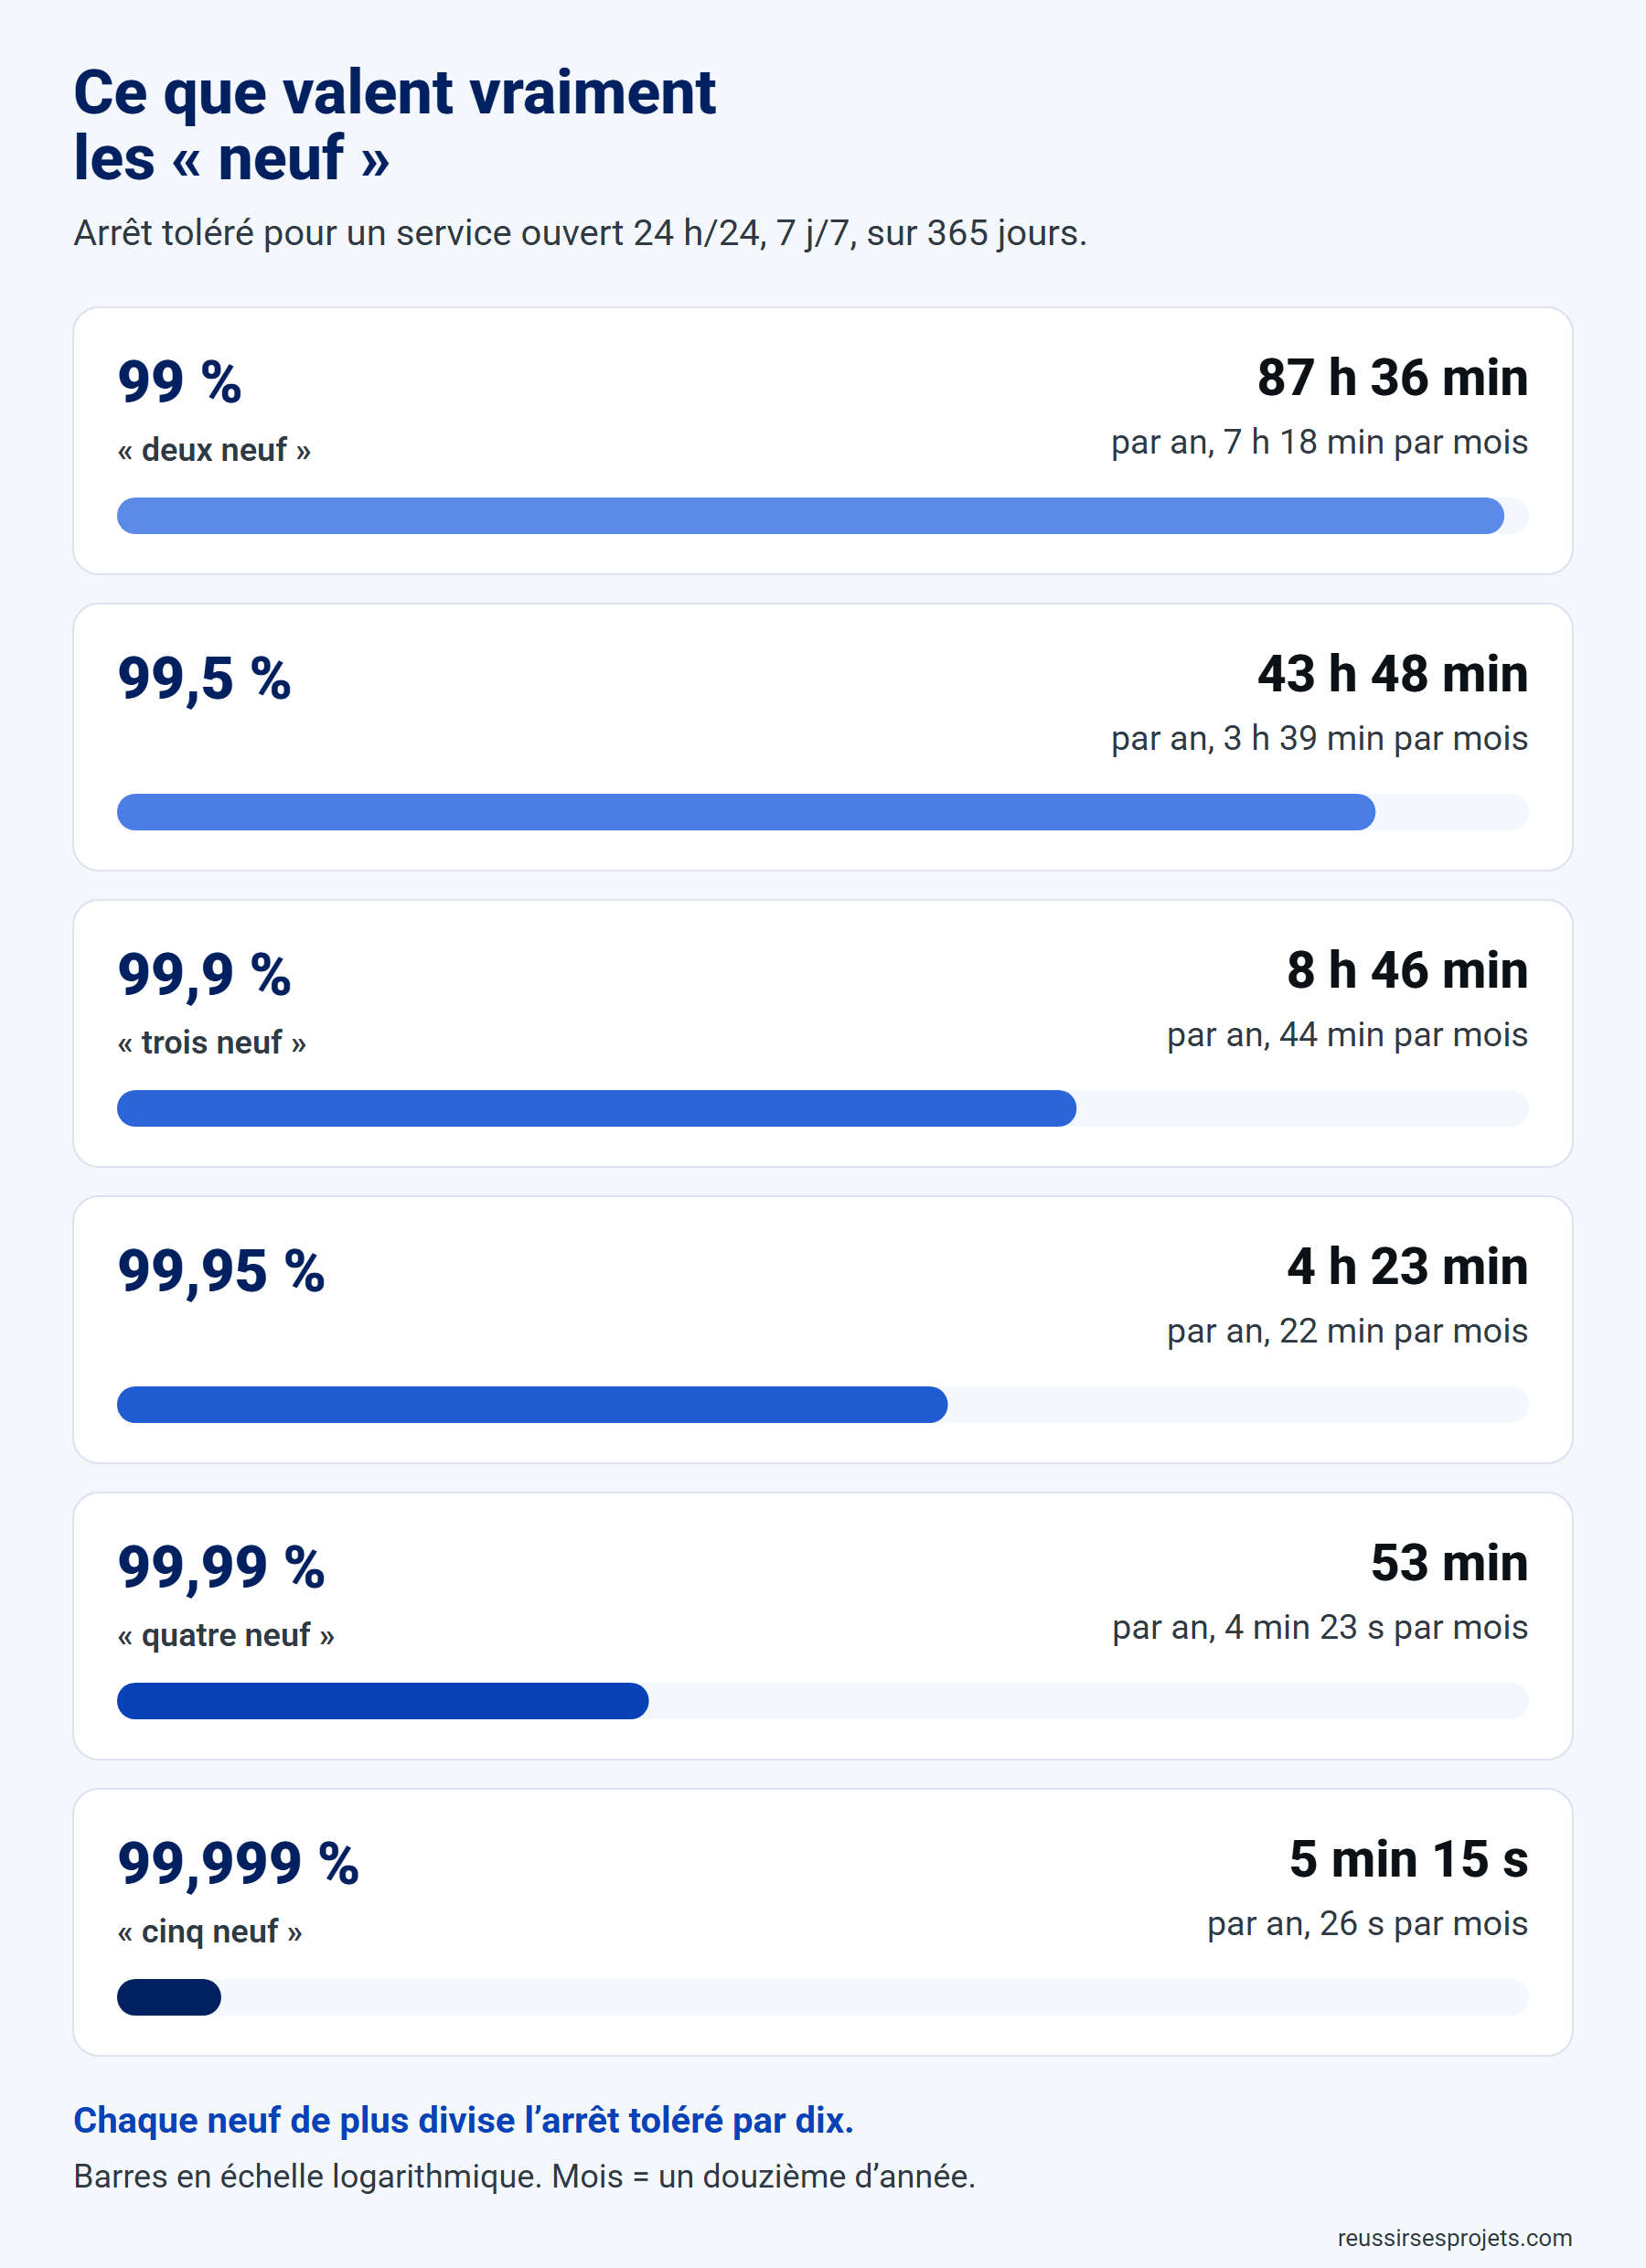
Les mois sont comptés comme un douzième d’année. Chaque neuf supplémentaire divise par dix le temps d’arrêt toléré, et multiplie souvent le coût de l’architecture. Avant de promettre un chiffre, demandez combien coûte une heure d’arrêt pour le métier. C’est ce qui justifie, ou non, l’investissement.
Plusieurs composants : en série et en parallèle
Un service repose sur plusieurs composants : serveurs, réseau, base de données, application. Deux règles de calcul, issues de la théorie de la fiabilité, permettent d’estimer la disponibilité de l’ensemble :
- en série, quand tous les composants doivent fonctionner : on multiplie leurs disponibilités
- en parallèle, quand un seul suffit : on calcule 1 moins le produit des indisponibilités.
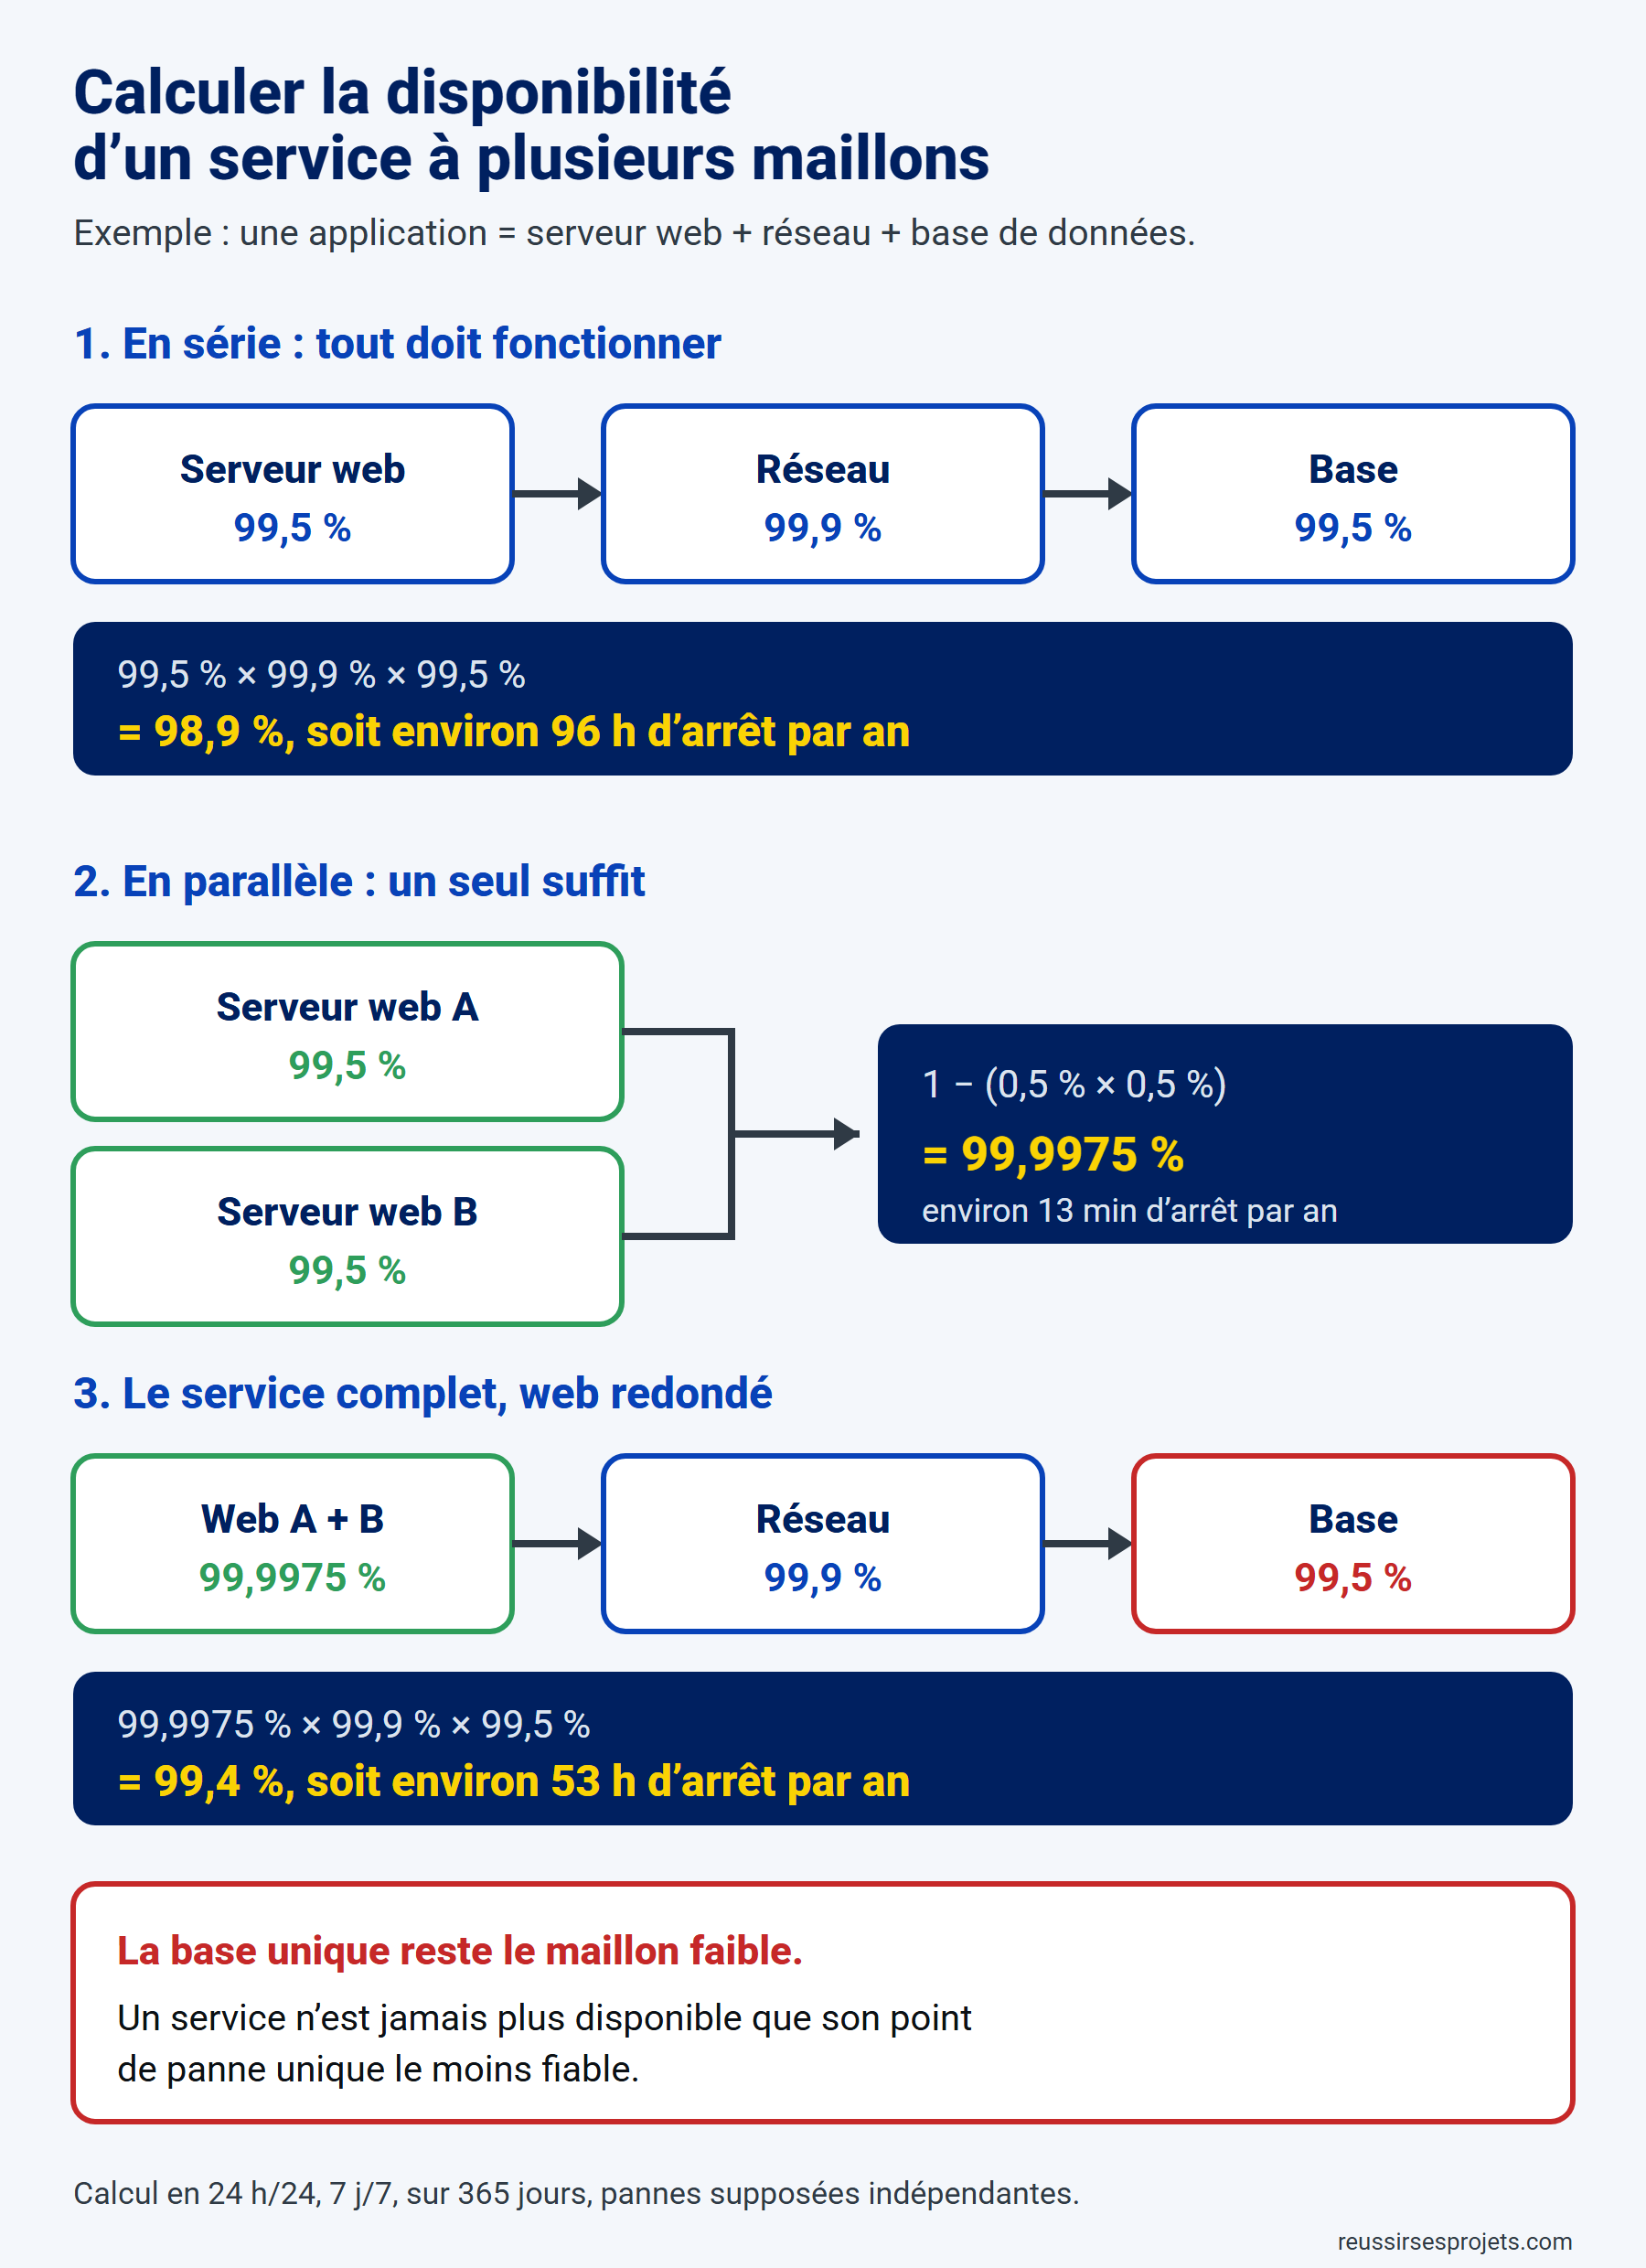
L’exemple montre la leçon la plus utile : doubler le serveur web ne sert pas à grand-chose si la base de données reste unique. Un service n’est jamais plus disponible que son point de panne unique le moins fiable. Ces calculs supposent que les pannes sont indépendantes. Deux serveurs dans la même salle, sur la même alimentation, ne le sont pas tout à fait.
MTBF, MTRS, MTBSI : mesurer fiabilité et rétablissement
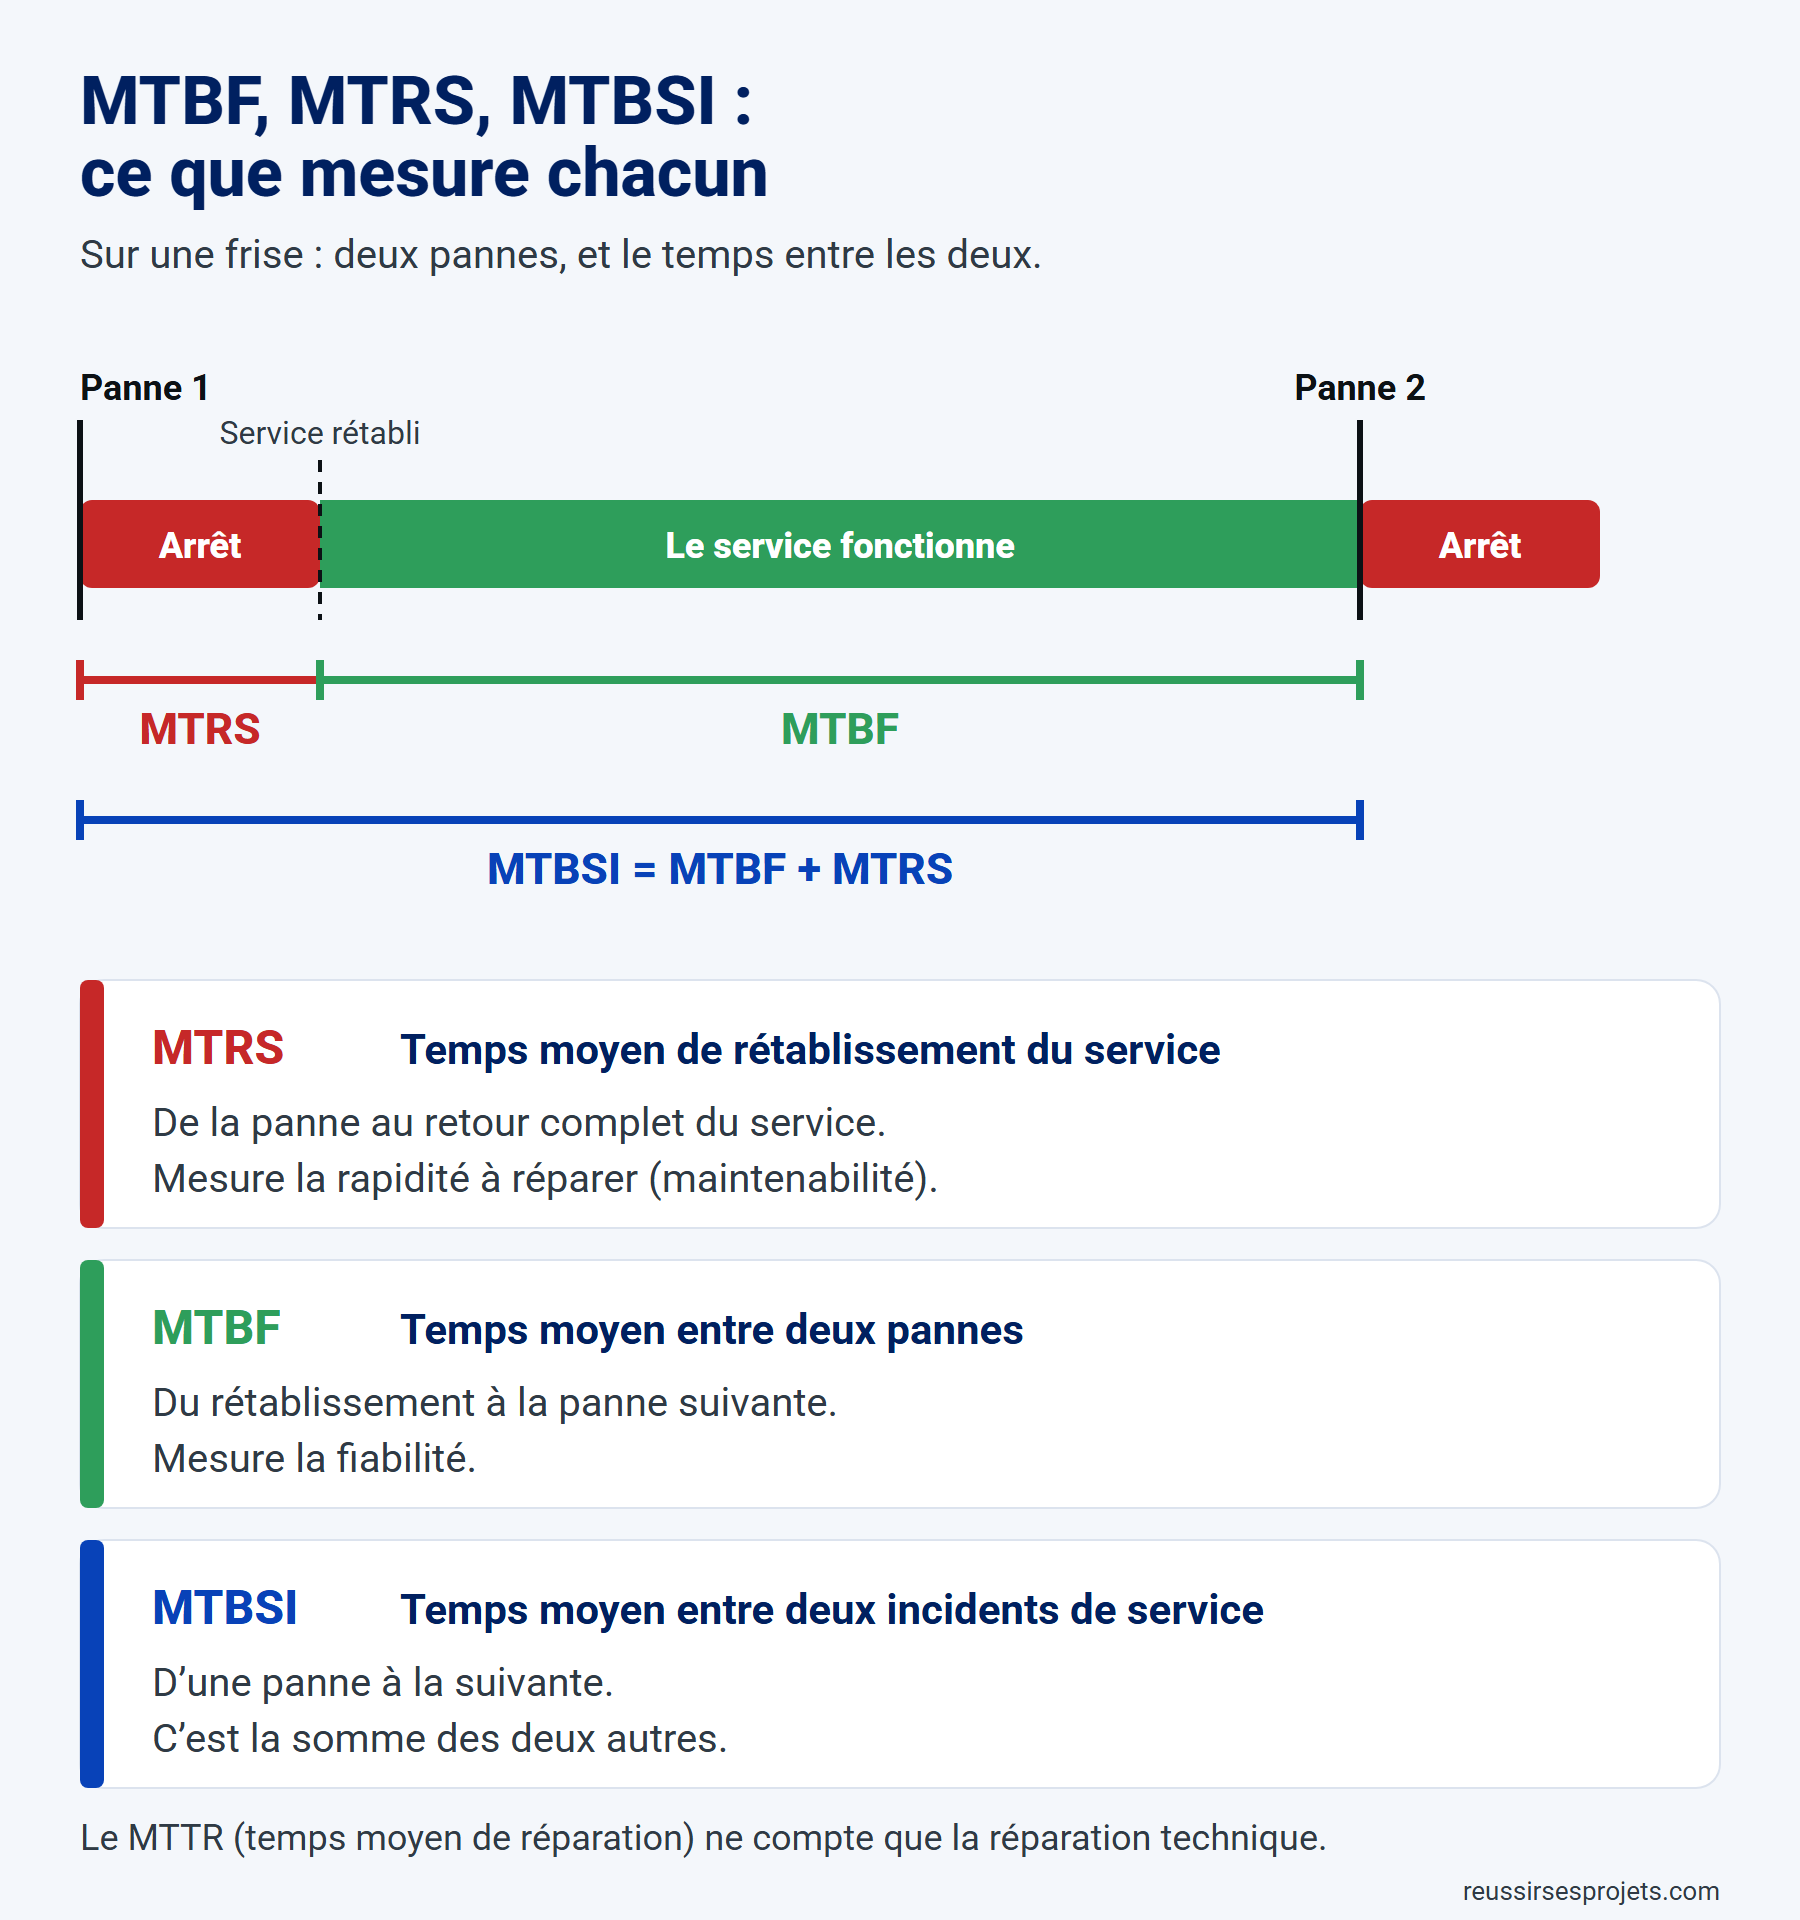
La disponibilité dit combien de temps le service a fonctionné. Elle ne dit pas comment : dix pannes de six minutes ou une panne d’une heure donnent le même chiffre. Trois indicateurs complètent le tableau.
| Indicateur | Signification | Ce qu’il mesure | Ce qu’il compte |
|---|---|---|---|
| MTRS (Mean Time to Restore Service) | Temps moyen de rétablissement du service | La rapidité à réparer, c’est-à-dire la maintenabilité | De la panne au retour complet du service |
| MTBF (Mean Time Between Failures) | Temps moyen entre deux pannes | La fiabilité | Du rétablissement à la panne suivante |
| MTBSI (Mean Time Between Service Incidents) | Temps moyen entre deux incidents de service | La fiabilité, vue d’une panne à l’autre | D’une panne à la suivante, soit MTBF + MTRS |
Le MTTR (Mean Time To Repair), temps moyen de réparation, est souvent employé à la place du MTRS. Il ne compte pourtant que la réparation technique, sans le temps nécessaire pour remettre le service à la disposition des utilisateurs. Le glossaire ITIL signale d’ailleurs que le MTTR est parfois utilisé à tort à la place du MTRS.
Un exemple chiffré
Un service ouvert 24 h/24 a connu 4 pannes dans l’année, pour un total de 10 heures d’arrêt.
| Indicateur | Calcul | Résultat |
|---|---|---|
| MTRS | 10 h ÷ 4 pannes | 2 h 30 |
| MTBF | (8 760 h − 10 h) ÷ 4 | environ 2 188 h, soit 91 jours |
| MTBSI | 8 760 h ÷ 4, ou MTBF + MTRS | 2 190 h |
| Disponibilité | (8 760 − 10) ÷ 8 760 | 99,89 % |
On retrouve d’ailleurs la disponibilité en divisant le MTBF par le MTBSI. Pour l’améliorer, il y a donc deux leviers : espacer les pannes (augmenter le MTBF, par la redondance et la prévention) ou rétablir plus vite (réduire le MTRS, par la supervision, les procédures et l’astreinte).
Le cycle de vie étendu de l’incident
Pour réduire le temps d’arrêt, ITIL découpe chaque panne en cinq étapes. Chacune est un levier.
- Détection : l’incident devient connu, par la supervision ou par un utilisateur.
- Diagnostic : on comprend ce qui se passe et l’on trouve un contournement.
- Réparation : on corrige ou remplace le composant défaillant.
- Récupération : on remet le composant en état de marche, souvent en remettant les données dans un état cohérent.
- Restauration : on rend le service aux utilisateurs.
Le MTTR, temps moyen de réparation, s’arrête à l’étape 3. Le MTRS va jusqu’à l’étape 5. Ce découpage montre où agir : une supervision mieux réglée raccourcit la détection, une base de connaissance le diagnostic, un stock de pièces ou un contrat fournisseur la réparation, des sauvegardes testées la récupération.
Les activités et les techniques
La gestion de la disponibilité mène deux types d’activités :
- des activités réactives : surveiller, mesurer, analyser et rendre compte de la disponibilité, enquêter sur les indisponibilités et lancer les actions correctives
- des activités proactives : identifier les fonctions métier vitales, concevoir pour la disponibilité, évaluer les risques, mettre en place des contre-mesures justifiées par leur coût, tester la résilience et tenir à jour le plan de disponibilité.
ITIL v3 décrit plusieurs techniques pour y parvenir :
| Technique | À quoi elle sert |
|---|---|
| Point de panne unique (SPOF) | Repérer les composants sans doublon dont la panne arrête le service. Ce peut être une personne ou une étape d’un processus. |
| Analyse d’impact des défaillances de composants (CFIA) | Croiser services et composants dans une matrice pour trouver les composants critiques et les services fragiles |
| Analyse par arbre de défaillances (FTA) | Représenter l’enchaînement d’événements qui mène, ou pourrait mener, à une panne |
| Analyse des défaillances de service (SFA) | Étudier, comme un petit projet limité dans le temps, les causes profondes d’interruptions et les améliorations possibles |
| Plan de disponibilité | Prévoir comment satisfaire les besoins de disponibilité actuels et futurs, pour un coût raisonnable |
| Système d’information de la gestion de la disponibilité (AMIS) | Rassembler les outils, données et informations nécessaires |
La disponibilité vue par l’utilisateur
Un piège classique : tous les composants affichent 99,9 %, le rapport mensuel est vert, et les utilisateurs se plaignent. Le serveur répondait, mais l’application était inutilisable, ou le réseau d’un site était coupé. On parle parfois d’« effet pastèque » : vert à l’extérieur, rouge à l’intérieur.
Pour l’éviter, mesurez au plus près de ce que vit l’utilisateur :
- des tests de bout en bout qui simulent une vraie transaction toutes les quelques minutes
- les incidents déclarés par les utilisateurs, rapprochés des chiffres de la supervision
- la disponibilité par site ou par population, pas seulement en moyenne.
Le moment de la panne compte aussi. Une heure d’arrêt à 3 h du matin et une heure d’arrêt à 10 h un jour de clôture comptable pèsent le même poids dans le pourcentage, mais pas pour le métier. C’est ce que permettent de traduire les fonctions métier vitales, et les plages de service différenciées dans le SLA.
Écrire un engagement de disponibilité qui tienne
Un engagement de disponibilité dans un SLA doit pouvoir être mesuré sans discussion. Voici ce qu’il doit préciser :
- le périmètre : quel service, quelles fonctions, pour quels utilisateurs
- la plage de service : jours, heures, fuseau horaire
- la cible et la période de mesure : par exemple 99,5 % par mois
- les exclusions : fenêtres de maintenance, causes extérieures, demandes du client
- la méthode de mesure : quel outil, quelle source fait foi
- ce qui se passe en cas d’écart : plan d’action, voire pénalités.
Avant de signer, vérifiez deux choses. L’architecture permet-elle d’atteindre la cible, d’après les calculs en série et en parallèle ? Et les contrats des fournisseurs sont-ils compatibles avec elle ? Promettre 99,9 % avec un support éditeur en J+1, c’est promettre un engagement non tenu.
Disponibilité et chef de projet
La disponibilité se décide au début d’un projet, pas à la fin. Un chef de projet qui livre un nouveau service a intérêt à :
- écrire la disponibilité attendue et la plage de service dans le cahier des charges, avec le coût d’une heure d’arrêt pour le métier
- faire valider l’architecture par ceux qui l’exploiteront, en repérant les points de panne uniques
- tester les bascules en recette, et pas seulement les fonctions
- prévoir la supervision et les procédures avant la mise en production, comme le détaille l’article sur la transition du build vers le run.
Les erreurs fréquentes
- Promettre avant de calculer. Un 99,9 % signé sur un serveur unique sans redondance est un engagement intenable.
- Oublier la plage horaire. Chacun calcule alors la disponibilité à sa façon.
- Ne mesurer que les composants. Les rapports sont verts, les utilisateurs mécontents.
- Doubler ce qui est déjà fiable. La redondance doit viser le maillon le plus faible.
- Négliger le rétablissement. Une panne rare mais longue coûte souvent plus cher que des pannes fréquentes et courtes.
La disponibilité dans ITIL 4 et ITIL 5
Dans ITIL 4, la gestion de la disponibilité est une pratique de gestion des services. Sa finalité officielle est de s’assurer que les services fournissent les niveaux de disponibilité convenus, pour répondre aux besoins des clients et des utilisateurs. La capacité et les performances d’un côté, la continuité des services de l’autre, sont des pratiques distinctes.
ITIL 4 insiste aussi sur un point que la v3 traitait moins : un indicateur isolé, comme un pourcentage de disponibilité d’un système, ne doit pas représenter à lui seul la qualité d’un service. Les engagements doivent être reliés aux résultats attendus par le métier et à l’expérience des utilisateurs, pas seulement à des mesures techniques. C’est la réponse à l’effet pastèque décrit plus haut.
ITIL 5, publié en 2026, conserve la pratique de gestion de la disponibilité parmi ses 34 pratiques. Les définitions et les calculs présentés ici restent valables.
Questions fréquentes sur la gestion de la disponibilité
Comment calculer la disponibilité d’un service informatique ?
On divise le temps pendant lequel le service a fonctionné par le temps de service convenu, puis on multiplie par 100. Par exemple, 2 heures d’arrêt sur 720 heures prévues donnent (720 − 2) ÷ 720, soit 99,7 %.
Que signifie une disponibilité de 99,9 % ?
Pour un service ouvert 24 h/24, 7 j/7, cela représente environ 8 h 46 d’arrêt toléré par an, soit 44 minutes par mois.
Quelle différence entre MTBF et MTTR ?
Le MTBF est le temps moyen de fonctionnement entre deux pannes. Le MTTR est le temps moyen de réparation. ITIL lui préfère le MTRS, le temps moyen de rétablissement du service, qui compte tout le délai jusqu’au retour complet du service.
Quelle différence entre MTBF et MTTF ?
Le MTBF s’applique à ce que l’on répare : c’est le temps moyen de fonctionnement entre deux pannes. Le MTTF, temps moyen avant défaillance, s’applique à ce que l’on remplace sans réparer, comme un disque dur : c’est sa durée de vie moyenne.
Faut-il exclure la maintenance planifiée du calcul ?
C’est un choix à écrire dans le SLA. L’exclure est courant, à condition de fixer les fenêtres de maintenance et de prévenir les utilisateurs. Sans règle écrite, la même coupure sera comptée par les uns et pas par les autres.
Quelle différence entre disponibilité et fiabilité ?
La fiabilité dit combien de temps un service fonctionne sans interruption. La disponibilité combine la fiabilité et la rapidité à rétablir. Un service peut être peu fiable mais très disponible, s’il redémarre en quelques secondes.
Quelle différence entre haute disponibilité et plan de reprise ?
La haute disponibilité évite que les pannes courantes arrêtent le service, grâce à la redondance. Le plan de reprise relève de la continuité : il prépare le redémarrage après un sinistre majeur, comme la perte d’une salle informatique.
Qu’est-ce qu’un point de panne unique ?
C’est un composant dont la panne suffit à arrêter tout le service, parce qu’il n’a pas de doublon : un serveur, une base, un lien réseau, parfois une seule personne qui sait tout réparer.
Sources
- Glossaire officiel ITIL 2011, entrées availability, availability management, reliability, maintainability, serviceability, resilience, agreed service time, downtime, vital business function, MTBF, MTBSI, MTRS, MTTR, expanded incident lifecycle, CFIA, FTA, SFA, single point of failure (Crown Copyright 2011).
- AXELOS, Introductory Overview of ITIL 4 (2020) : pratiques de gestion des services.
- PeopleCert, questions fréquentes sur ITIL (Version 5).
- AWS, pilier Fiabilité du cadre Well-Architected : la disponibilité : calculs en série et en parallèle.

Thibault Baheux
Expert en pilotage de projets IT & transformations complexes
Responsable de pôle infrastructure IT, auteur et fondateur de Réussir Ses Projets, je manage 15 personnes en direct et je pilote un portefeuille de projets.
Depuis 2008, je suis passé de l'administration système à la direction de projet. Depuis 2020, je transmets sur ce site des méthodes nées du terrain, à travers des articles, des livres, des outils et des formations.
Certifications


À lire ensuite
 Transformation ITProcessus ITIL : les 26 processus v3 et les 34 pratiques ITIL 413 min de lecture
 Transformation ITAmélioration continue ITIL : les 7 étapes de la v3 et le modèle d’ITIL 412 min de lecture
 Transformation ITExploitation des services ITIL : les 5 processus et les 4 fonctions14 min de lecture