Gestion des problèmes ITIL : analyse de cause, erreur connue
Sommaire 12 parties
- Qu’est-ce que la gestion des problèmes ?
- Quand ouvrir un problème ?
- Les étapes de la gestion des problèmes
- Les techniques d’analyse : choisir la bonne
- L’erreur connue et sa fiche
- La revue de problème majeur
- Les indicateurs de la gestion des problèmes
- Le point de vue du responsable d’équipe
- La gestion des problèmes dans ITIL 4 et ITIL 5
- Les erreurs fréquentes
- Questions fréquentes sur la gestion des problèmes ITIL
- Sources
La gestion des problèmes ITIL cherche la cause des incidents et la supprime, pour qu’ils ne reviennent pas. Elle analyse les pannes répétées ou graves, documente les erreurs connues et leurs contournements, puis déclenche la correction définitive. C’est elle qui transforme une équipe qui éteint des incendies en une équipe qui les prévient.
Dans beaucoup d’équipes, la gestion des problèmes est ce que l’on reporte en premier quand l’activité déborde, alors que c’est elle qui finit par réduire la charge. Dans ce guide, je vous explique ce que dit ITIL, quand ouvrir un problème, comment choisir la bonne technique d’analyse, comment rédiger une erreur connue, et ce qui change dans ITIL 4 et ITIL 5.
- Un problème est la cause, connue ou non, d’un ou plusieurs incidents.
- La gestion des incidents rétablit le service. La gestion des problèmes supprime la cause.
- Une erreur connue est un problème dont la cause est comprise. Elle s’accompagne souvent d’un contournement, partagé avec le centre de services.
- La gestion des problèmes est réactive (après des incidents) et proactive (avant qu’ils ne se produisent).
- La correction définitive passe en général par un changement.
Qu’est-ce que la gestion des problèmes ?
Selon le glossaire ITIL, un problème est la cause d’un ou plusieurs incidents. Au moment où on l’enregistre, cette cause est en général inconnue : c’est justement le rôle de la gestion des problèmes de la trouver. ITIL 4 élargit la définition à la cause « potentielle » : on peut ouvrir un problème avant même qu’un incident se produise. C’est l’une des pratiques d’exploitation du référentiel ITIL.
La gestion des problèmes pilote le cycle de vie de tous les problèmes. Elle prévient les incidents quand c’est possible, et réduit l’impact de ceux que l’on ne peut pas éviter. ITIL 4 résume son objectif ainsi : réduire la probabilité et l’impact des incidents, en identifiant leurs causes réelles et potentielles, et en gérant les contournements et les erreurs connues.
Trois autres notions reviennent sans cesse :
- le contournement : une solution qui réduit ou supprime l’effet d’un incident ou d’un problème, en attendant la résolution complète, comme redémarrer un composant
- l’erreur connue : un problème dont la cause est comprise, décrite plus bas
- la base des erreurs connues (KEDB, Known Error Database, parfois appelée BDEC en français) : la base qui rassemble toutes les erreurs connues, alimentée par la gestion des problèmes et consultée par la gestion des incidents.
Incident, problème, erreur connue : un exemple
La différence se comprend mieux sur un cas concret, ici fictif : une application de paie qui plante chaque fin de mois.
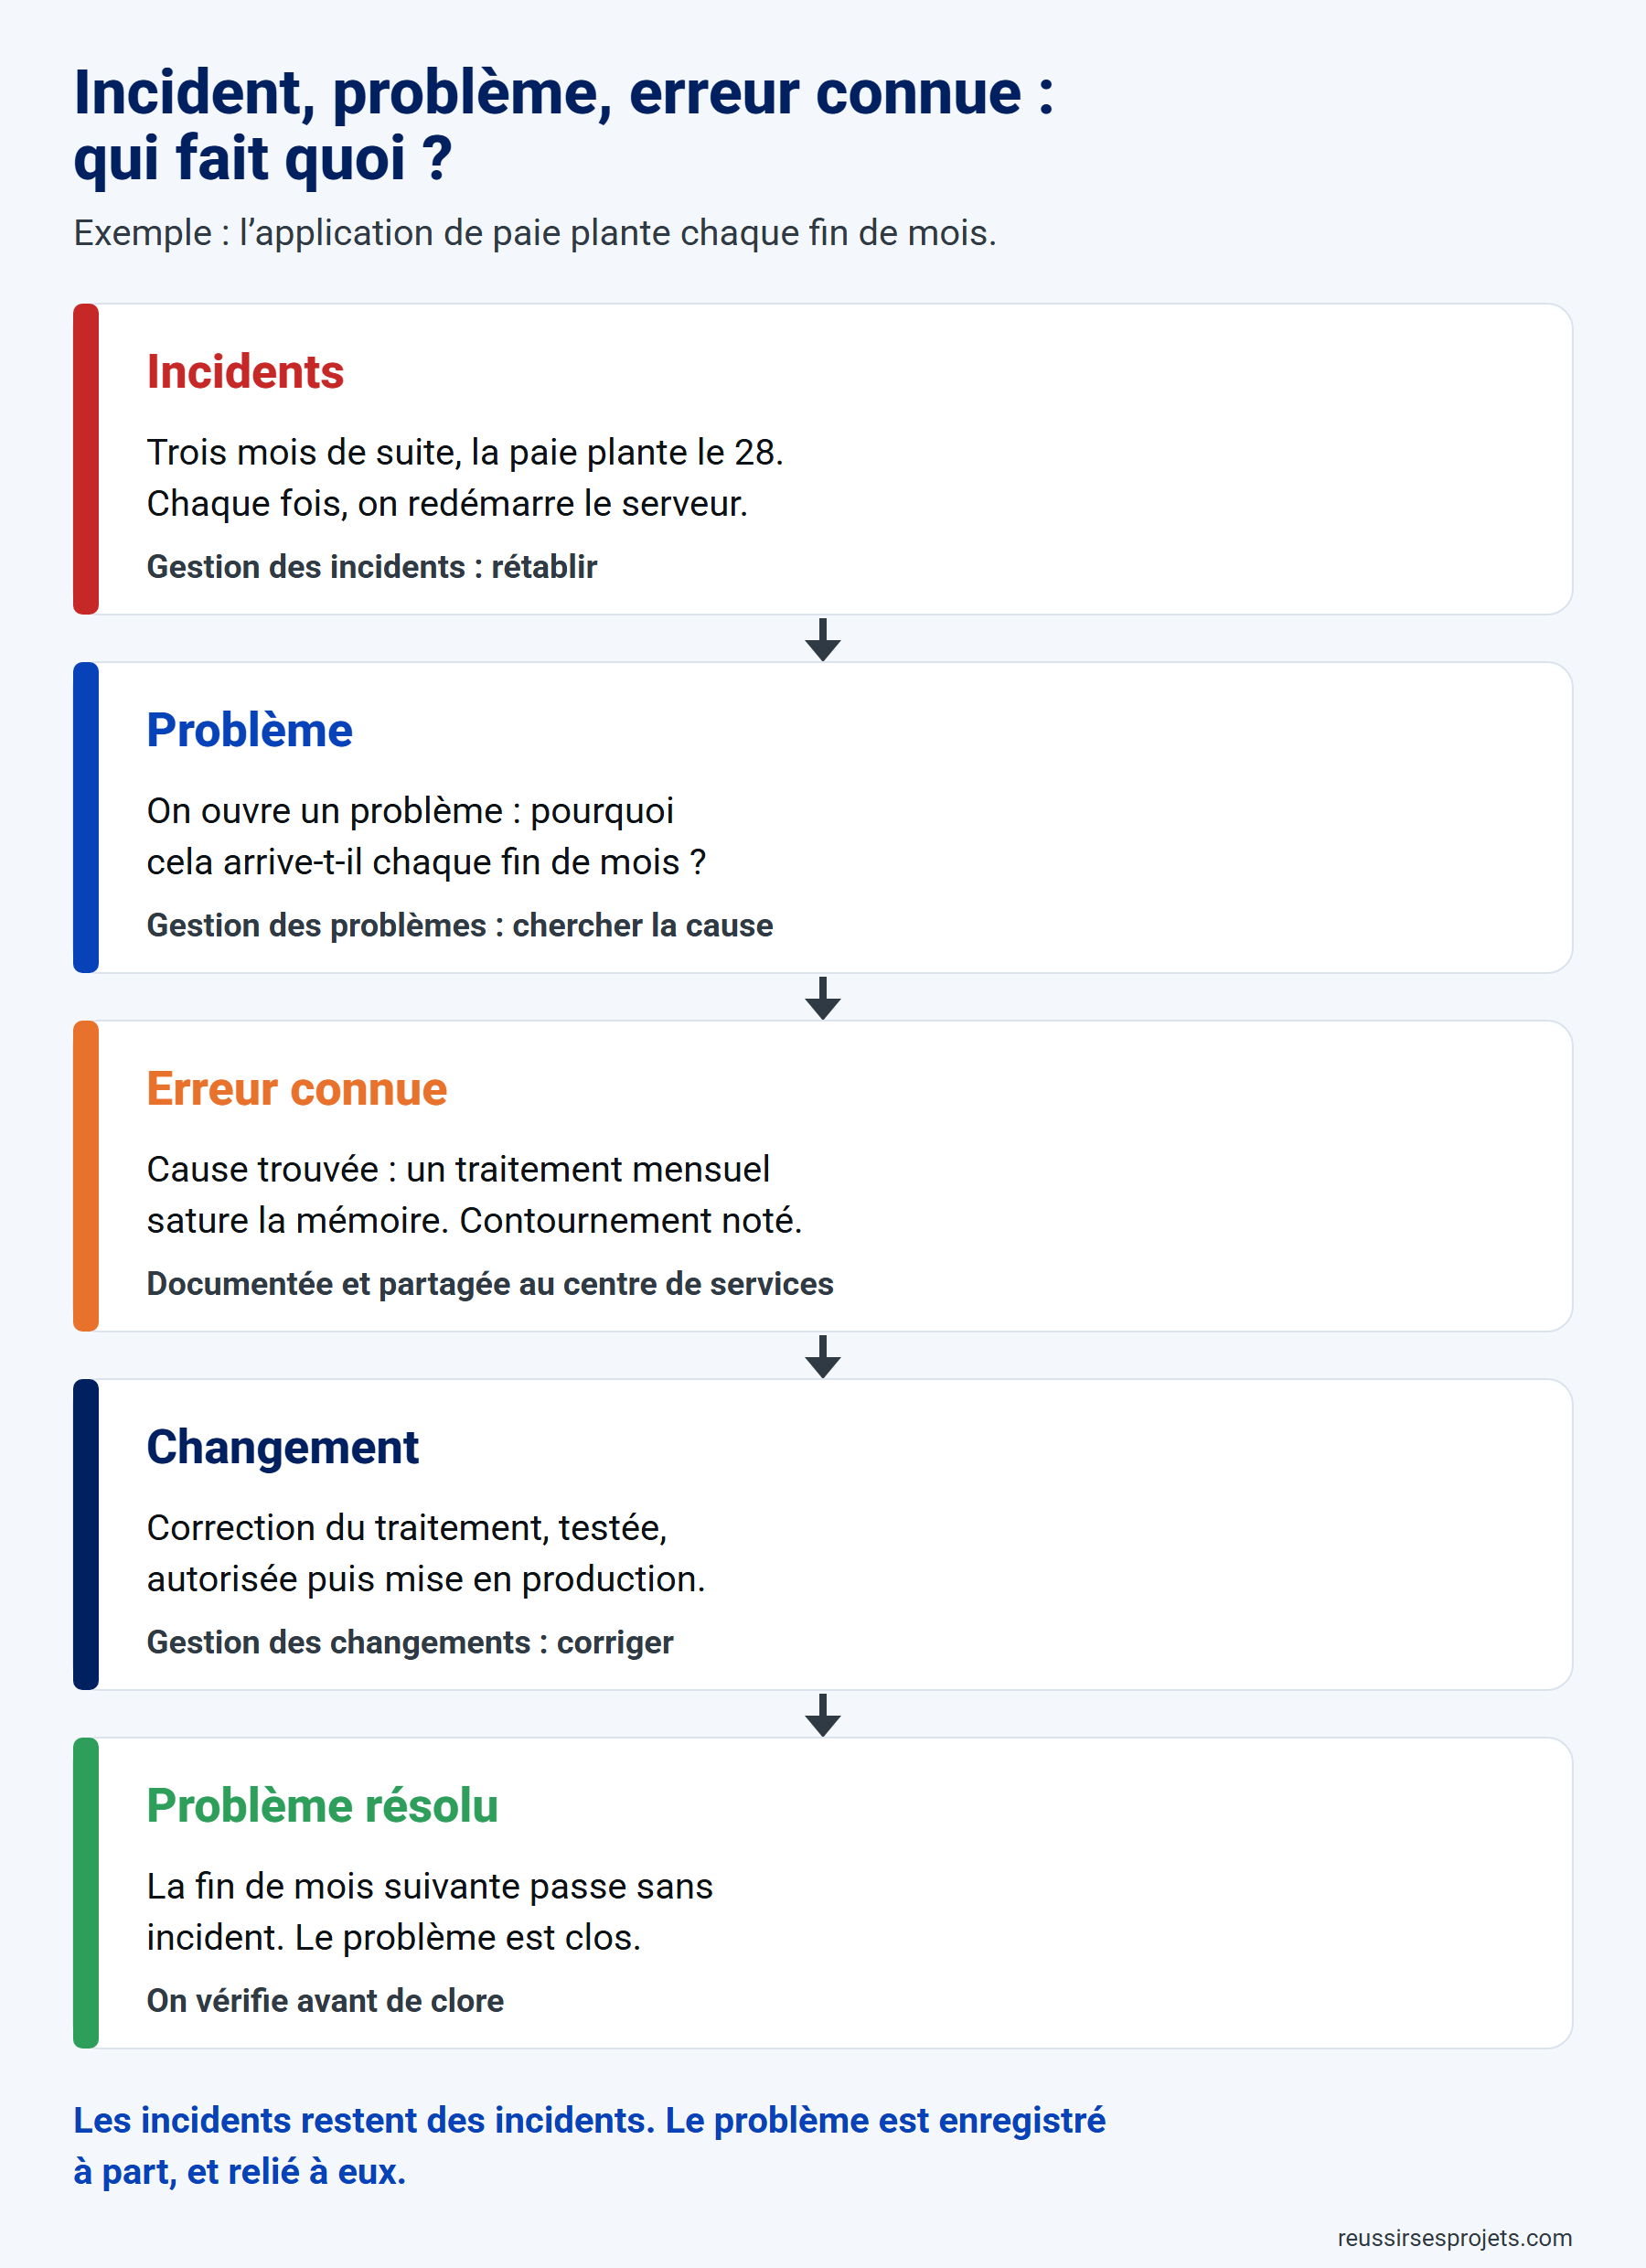
Pendant trois mois, la gestion des incidents a fait son travail : la paie a été rétablie chaque fois. Mais sans gestion des problèmes, elle aurait planté encore le mois suivant, et celui d’après. C’est l’ouverture du problème qui a permis de trouver la cause, de partager un contournement, puis de corriger pour de bon.
Réactive et proactive
ITIL distingue deux façons de travailler :
- la gestion réactive part d’incidents qui se sont produits : un incident majeur, des incidents qui se répètent, une panne dont personne ne connaît la cause
- la gestion proactive cherche les problèmes qui passeraient sinon inaperçus, en analysant les tickets et les données de supervision pour repérer des tendances, des composants fragiles ou des pannes mineures qui annoncent une panne majeure.
Dans ITIL v3, le volet réactif relève de l’exploitation, et le volet proactif est surtout piloté avec l’amélioration continue. Dans la plupart des DSI, on commence par le réactif, et le proactif vient quand l’équipe a du temps pour regarder les tendances.
Quand ouvrir un problème ?
Le livre ITIL sur l’exploitation cite plusieurs situations qui doivent conduire à ouvrir un problème :
- le centre de services a rétabli un incident sans en connaître la cause, et craint qu’il ne revienne
- un incident risque de se reproduire, constat fait au moment de sa clôture
- une équipe technique, en analysant un incident, découvre une cause plus profonde
- les outils de supervision détectent automatiquement une anomalie
- un fournisseur signale un défaut de son produit
- l’analyse des tendances fait ressortir des incidents qui se ressemblent
- une mise en production part avec des défauts connus, repérés pendant les tests.
ITIL 4 ajoute explicitement la gestion des incidents majeurs parmi les sources : après un incident majeur, la question « pourquoi ? » doit toujours être posée.
Les étapes de la gestion des problèmes
Le livre ITIL consacré à l’exploitation décrit 10 étapes pour la gestion réactive des problèmes. Certaines se répètent, le temps de trouver la bonne piste.
- Détection. Le problème est repéré, à partir d’une des situations décrites plus haut.
- Enregistrement. Il a sa propre fiche, reliée aux incidents qui l’ont révélé.
- Catégorisation. On le classe avec les mêmes catégories que les incidents, pour pouvoir les rapprocher.
- Priorisation. Comme pour un incident, on croise impact et urgence, en tenant compte de la fréquence des incidents liés et de la gravité : coût, nombre de personnes et de composants touchés.
- Investigation et diagnostic. On cherche la cause, avec les techniques présentées plus bas, en reproduisant si possible la panne sur un environnement de test.
- Contournement. Si une solution provisoire existe, on la documente. Le problème reste ouvert.
- Création de l’erreur connue. Dès que la cause est comprise, et surtout si un contournement existe, on crée la fiche d’erreur connue pour la partager.
- Résolution. La correction définitive est mise en œuvre, en général par une demande de changement.
- Clôture. On vérifie que la correction a fonctionné, on clôt les incidents liés encore ouverts et l’on met à jour l’erreur connue.
- Revue de problème majeur. Pour les problèmes les plus graves, on tire les leçons de l’ensemble.
Parfois, la correction coûte plus cher que le problème. On garde alors le problème ouvert avec un statut particulier, et l’on continue d’appliquer le contournement. C’est une décision à prendre consciemment, et à revoir de temps en temps.
Les techniques d’analyse : choisir la bonne
Trouver la cause d’un problème demande de la méthode. Le livre ITIL consacré à l’exploitation cite plusieurs techniques. Aucune n’est meilleure que les autres : tout dépend de la situation.
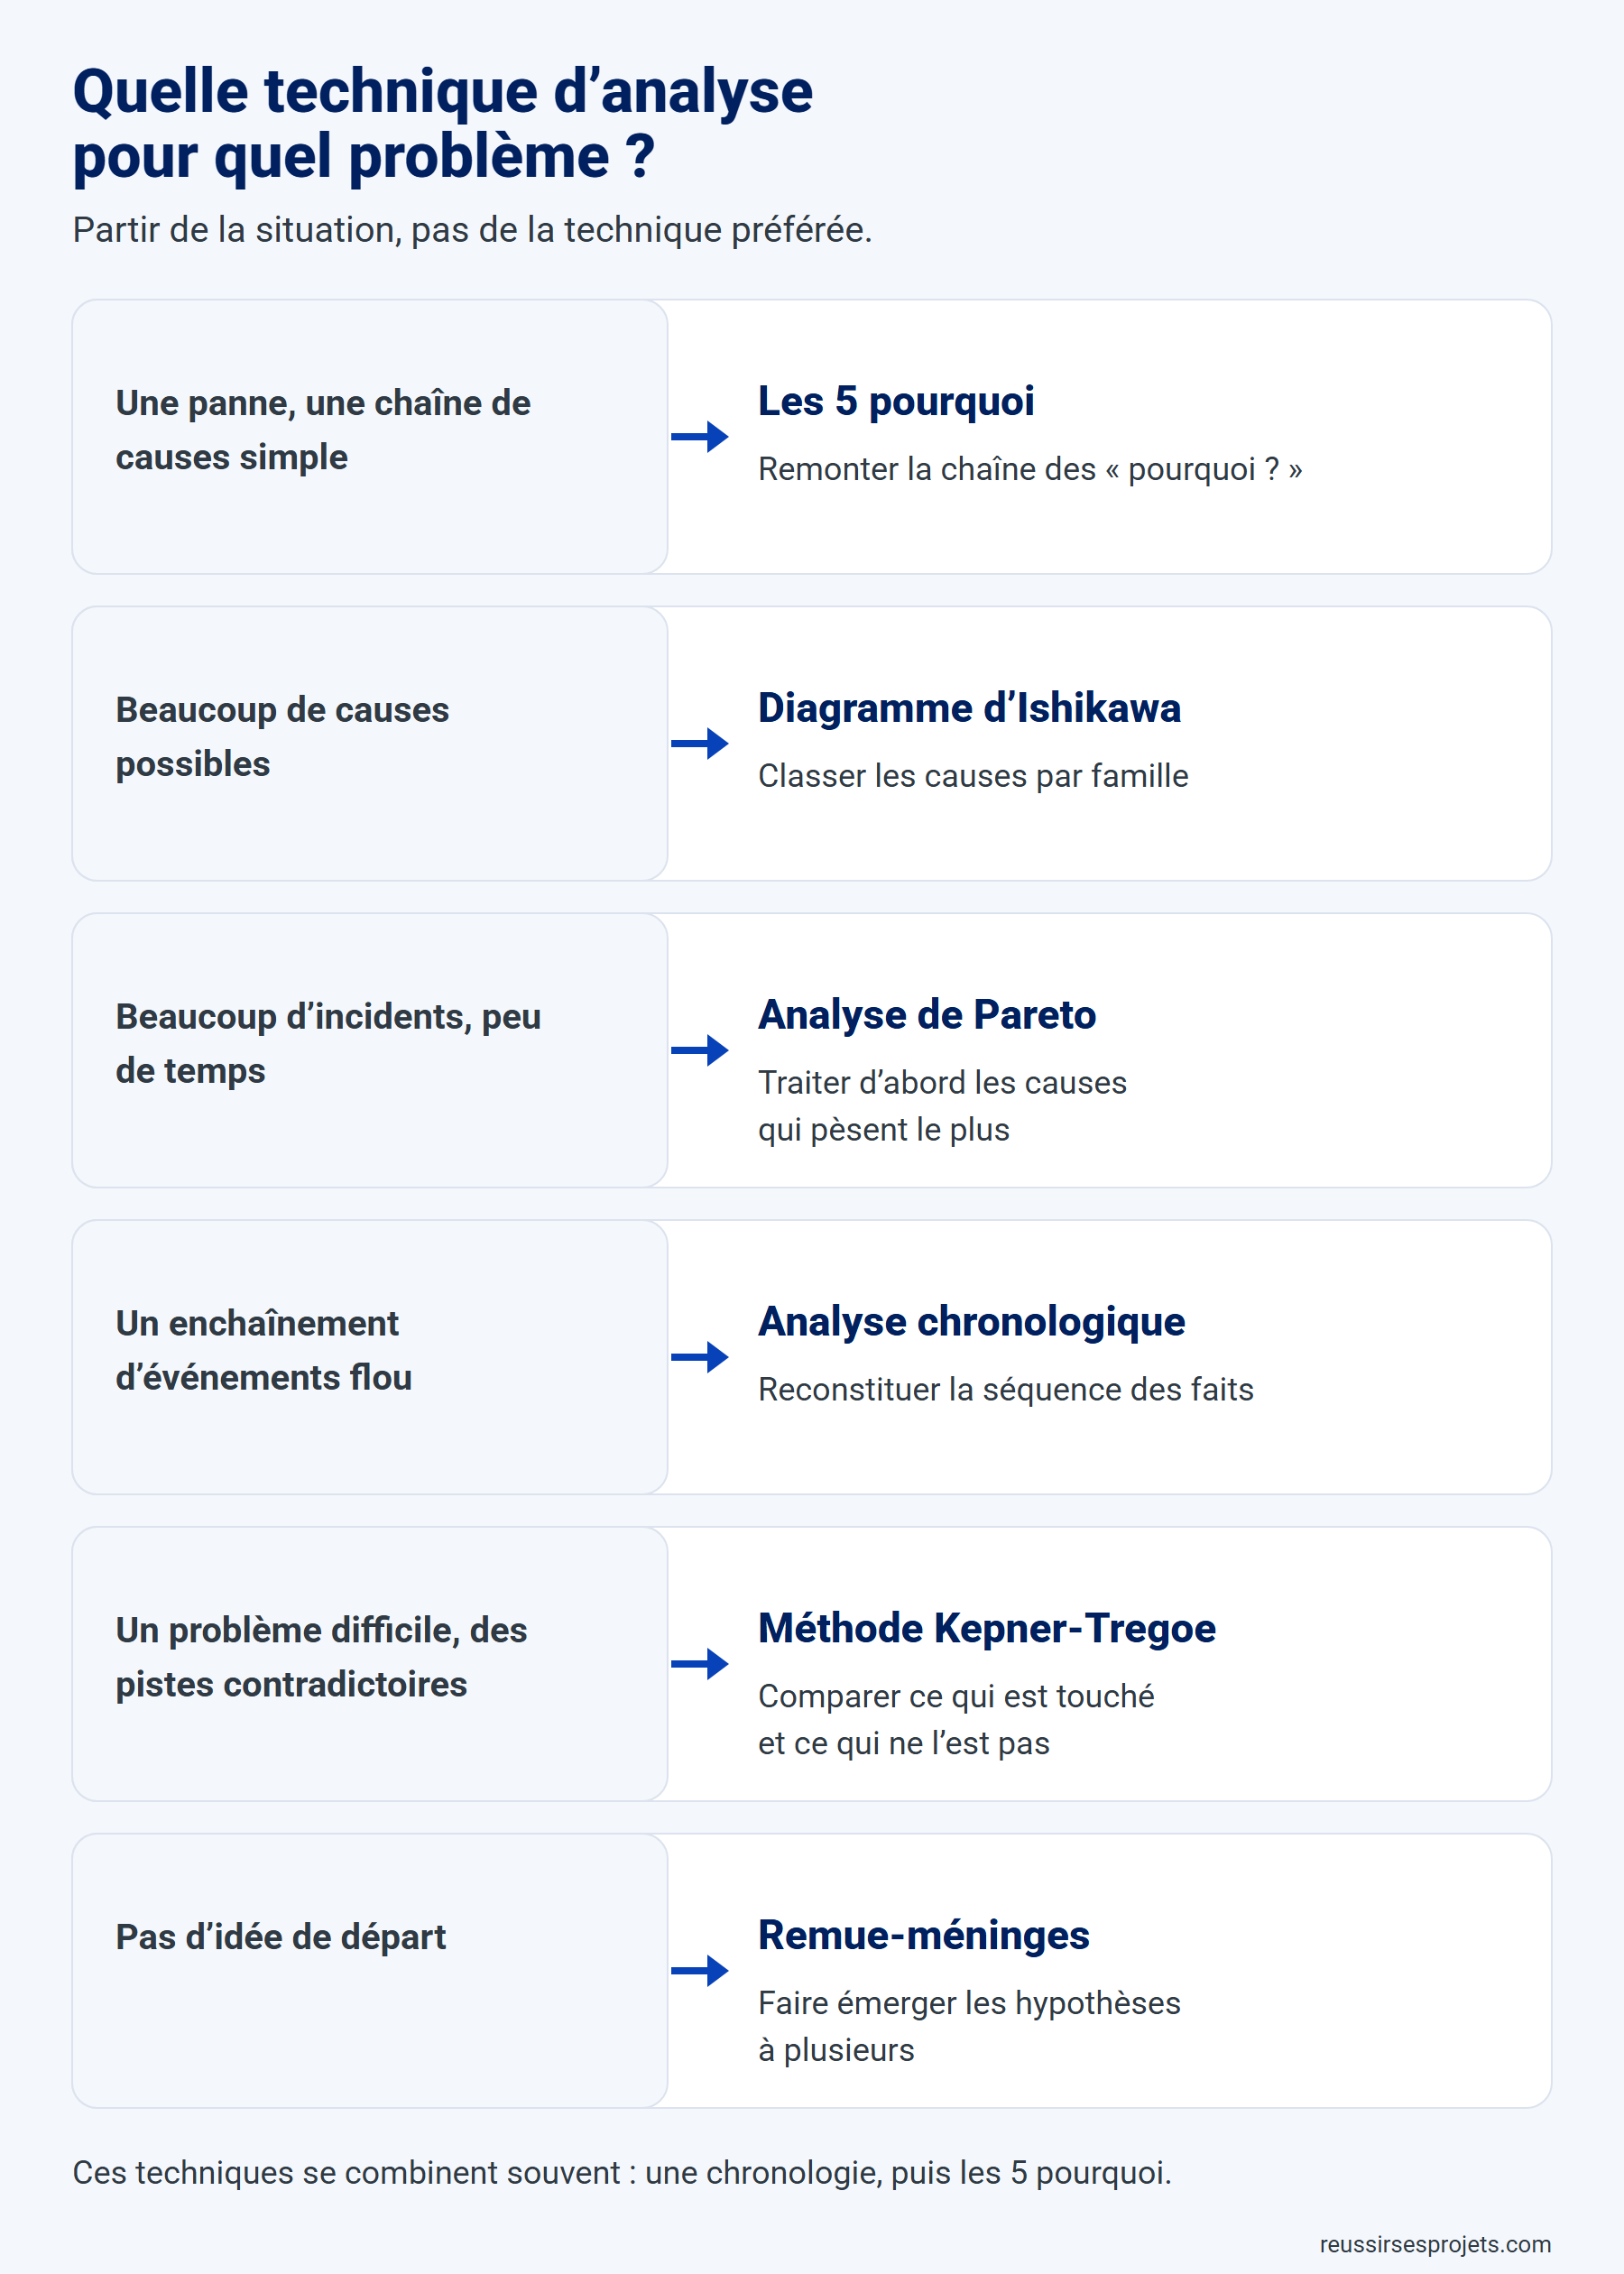
- L’analyse chronologique : rassembler et trier toutes les données par date et heure, pour voir quel événement en a déclenché un autre.
- L’analyse de la valeur de la douleur (pain value analysis) : mesurer le poids d’un problème pour l’entreprise, selon le nombre d’utilisateurs touchés, la durée des interruptions et leur coût. Elle aide à choisir les problèmes à traiter en premier.
- La méthode Kepner-Tregoe : décrire précisément le problème (quoi, où, quand, quelle étendue), établir les causes possibles, tester la plus probable, puis vérifier la vraie cause.
- Le remue-méninges : produire des hypothèses à plusieurs, sans les juger pendant la séance.
- Le diagramme d’Ishikawa, en arête de poisson : classer toutes les causes possibles par famille.
- L’analyse de Pareto : repérer les quelques causes qui expliquent la plupart des pannes, pour les traiter d’abord.
La technique la plus utilisée sur le terrain n’est pas dans cette liste : la méthode des 5 pourquoi, qui consiste à demander « pourquoi ? » jusqu’à atteindre la cause. Elle suffit souvent pour une chaîne de causes simple. Pour cadrer un problème complexe, la méthode QQOQCCP est aussi très utile.
L’erreur connue et sa fiche
Une erreur connue est un problème dont on a compris la cause. Les deux versions d’ITIL ne la définissent pas tout à fait de la même façon :
- dans ITIL v3 (2011), c’est un problème dont la cause racine et un contournement sont documentés
- dans ITIL 4, c’est un problème qui a été analysé mais pas encore résolu, ce qui signifie en général que les composants défaillants sont identifiés. Le contournement n’est plus exigé.
Dans les deux cas, l’erreur connue sert à la même chose : permettre au centre de services de reconnaître la panne et d’appliquer le contournement tout de suite, sans repasser par les experts.
Voici les rubriques que je recommande pour une fiche d’erreur connue, avec l’exemple de la paie :
| Rubrique | Exemple |
|---|---|
| Référence et titre | EC-2026-031 : la paie plante le 28 du mois |
| Symptômes | Message « mémoire insuffisante », plus aucun bulletin ne se génère |
| Services et composants touchés | Application de paie, serveur de traitement |
| Cause | Le traitement mensuel des congés charge toutes les données en mémoire |
| Contournement | Lancer le traitement des congés la veille, de nuit, avant la paie |
| Correction prévue | Changement CHG-2026-0388, prévu le 15 du mois prochain |
| Incidents liés | Les trois incidents des trois derniers mois |
| Responsable | Équipe applicative paie |
Le centre de services doit pouvoir la trouver en quelques secondes, à partir des symptômes que décrit l’utilisateur. Une erreur connue que personne ne trouve ne sert à rien.
La revue de problème majeur
Après chaque problème majeur, ITIL recommande une revue, tant que les faits sont frais. Elle examine cinq questions :
- Qu’est-ce qui a été bien fait ?
- Qu’est-ce qui a été mal fait ?
- Que pourrait-on mieux faire la prochaine fois ?
- Comment éviter que le problème ne se reproduise ?
- Un tiers, un fournisseur par exemple, a-t-il une responsabilité, et faut-il un suivi ?
Les leçons rejoignent ensuite les procédures, les scripts de diagnostic, les erreurs connues et la formation des équipes, puis la revue de service avec le client.
Une revue utile cherche à comprendre, pas à désigner un coupable. Si l’équipe craint d’être sanctionnée, elle cache les erreurs, et l’on ne corrige rien. C’est le même esprit qu’un bon retour d’expérience projet.
Les indicateurs de la gestion des problèmes
Le livre ITIL sur l’exploitation cite une dizaine d’indicateurs. Voici ceux que je recommande de suivre en priorité :
| Indicateur | Ce qu’il montre |
|---|---|
| Nombre de problèmes ouverts et sa tendance | Si l’équipe rattrape son retard ou s’enlise |
| Part des problèmes résolus dans le délai cible | La capacité à aller au bout |
| Nombre d’erreurs connues ajoutées à la base | Ce que la pratique rend au centre de services |
| Exactitude de la base des erreurs connues | La confiance que l’on peut lui accorder |
| Nombre de problèmes majeurs, et part des revues menées dans les délais | La rigueur sur les cas graves |
| Évolution des incidents récurrents | Le résultat réel : moins de pannes qui reviennent |
Le dernier n’est pas dans la liste d’ITIL, mais c’est celui qui convainc le mieux une direction : si les mêmes incidents reviennent moins, la gestion des problèmes fonctionne.
Le point de vue du responsable d’équipe
La gestion des problèmes ne rapporte rien tout de suite. Elle demande du temps d’expert, alors que l’incident suivant attend déjà. C’est pour cela qu’elle passe souvent après tout le reste, et que les mêmes pannes reviennent. Trois habitudes aident à la faire vivre :
- réserver un créneau fixe chaque semaine, par exemple une demi-journée par expert, pour les problèmes ouverts
- suivre peu de problèmes à la fois, mais jusqu’au bout, plutôt qu’une longue liste qui n’avance pas
- montrer les résultats : les incidents évités, les heures gagnées. C’est ce qui justifie le temps passé auprès de la direction.
La gestion des problèmes rejoint aussi la gestion des risques : une erreur connue non corrigée est un risque accepté, qu’il faut suivre comme tel.
La gestion des problèmes dans ITIL 4 et ITIL 5
Dans ITIL 4, la gestion des problèmes est une pratique de gestion des services. Elle s’organise en trois phases :
| Phase | Ce que l’on y fait |
|---|---|
| Identification des problèmes | Repérer les problèmes : tendances des incidents, incidents répétés, incidents majeurs, informations des fournisseurs, des développeurs, des équipes de test et de projet |
| Contrôle des problèmes | Prioriser selon les risques, analyser, documenter les contournements et les erreurs connues |
| Contrôle des erreurs | Gérer les erreurs connues, chercher des solutions définitives, justifier une demande de changement, réévaluer régulièrement |
ITIL 4 insiste sur les liens avec les autres pratiques : la gestion des incidents, avec qui les activités se complètent mais peuvent entrer en conflit, l’habilitation des changements pour la correction, la gestion des connaissances pour partager les contournements, la gestion des risques et l’amélioration continue. Il admet aussi qu’un contournement devienne la solution permanente, quand corriger ne vaut pas le coût : le problème reste alors une erreur connue.
En 2023, PeopleCert a publié une version révisée de la pratique, dans une première série de cinq pratiques avec les incidents, les demandes de service, les événements et le centre de services. ITIL 5, publié en 2026, conserve la gestion des problèmes parmi ses 34 pratiques, dans le module de certification « Monitor, Support and Fulfil ».
Les erreurs fréquentes
- Confondre incident et problème. On cherche la cause pendant que les utilisateurs attendent, au lieu de rétablir d’abord.
- Ouvrir des problèmes sans les traiter. La liste s’allonge, personne n’y passe de temps, et la pratique perd sa crédibilité.
- S’arrêter au premier « pourquoi ». On corrige le symptôme, pas la cause, et le problème revient sous une autre forme.
- Ne pas partager les contournements. Le centre de services réinvente la solution à chaque appel.
- Clore sans vérifier. La correction est déployée, mais personne ne contrôle que les incidents ont vraiment cessé.
Questions fréquentes sur la gestion des problèmes ITIL
Quelle différence entre un incident et un problème ?
L’incident est l’interruption ou la dégradation d’un service : on le rétablit au plus vite. Le problème est la cause d’un ou plusieurs incidents : on la cherche, puis on la supprime. Un incident ne devient jamais un problème : les deux sont enregistrés à part, puis reliés.
Qu’est-ce qu’une erreur connue ?
C’est un problème dont la cause a été analysée, mais pas encore corrigée. Elle s’accompagne souvent d’un contournement, qui permet de rétablir le service plus vite en attendant la correction.
Qu’est-ce qu’un contournement ?
C’est une solution qui réduit ou supprime l’effet d’un incident ou d’un problème, sans en traiter la cause. Redémarrer un serveur, lancer un traitement à une autre heure ou utiliser une procédure de secours sont des contournements.
Quelle différence entre gestion réactive et proactive des problèmes ?
La gestion réactive part d’incidents qui se sont produits. La gestion proactive cherche les problèmes avant qu’ils ne provoquent des incidents, en analysant les tendances, les alertes ou les incidents mineurs répétés.
Quelle méthode utiliser pour trouver la cause d’un problème ?
Cela dépend de la situation. Les 5 pourquoi suffisent pour une chaîne de causes simple. Le diagramme d’Ishikawa aide quand les causes possibles sont nombreuses. L’analyse de Pareto sert à choisir les problèmes à traiter en premier, et l’analyse chronologique à reconstituer un enchaînement d’événements.
Peut-on clore un incident sans connaître sa cause ?
Oui. L’incident est clos dès que le service est rétabli pour l’utilisateur. Si la cause reste inconnue et que la panne risque de revenir, on ouvre un problème, enregistré à part. C’est justement ce qui permet de ne pas laisser les incidents ouverts indéfiniment.
Quand clore un problème ?
Quand la correction définitive est en place et que l’on a vérifié que les incidents liés ont cessé. On clôt alors aussi les incidents encore ouverts, et l’on met à jour l’erreur connue. Un problème dont on accepte de garder le contournement reste ouvert, avec un statut particulier.
Qui est responsable de la gestion des problèmes ?
ITIL prévoit un gestionnaire des problèmes, qui pilote la pratique, anime les revues et veille à ce que chaque problème ait un responsable. L’analyse elle-même est faite par les équipes techniques concernées. Dans une petite DSI, ce rôle est souvent tenu par le responsable de la production ou par un expert expérimenté.
Quelles sont les phases de la gestion des problèmes dans ITIL 4 ?
Il y en a trois : l’identification des problèmes, le contrôle des problèmes, qui analyse et documente, et le contrôle des erreurs, qui gère les erreurs connues jusqu’à leur correction.
Sources
- Glossaire officiel ITIL 2011, entrées problem, problem management, known error, known error database, workaround, root cause analysis, proactive problem management, chronological analysis, pain value analysis, Kepner and Tregoe analysis, Ishikawa diagram, Pareto principle (Crown Copyright 2011).
- ITIL Service Operation, édition 2007 : étapes de la gestion des problèmes (section 4.4.5), techniques d’analyse, revue de problème majeur, indicateurs (section 4.4.8).
- AXELOS, Introductory Overview of ITIL 4 (2020).
- PeopleCert, ITIL 4 Management Practices 2023.
- PeopleCert, questions fréquentes sur ITIL (Version 5).

Thibault Baheux
Expert en pilotage de projets IT & transformations complexes
Responsable de pôle infrastructure IT, auteur et fondateur de Réussir Ses Projets, je manage 15 personnes en direct et je pilote un portefeuille de projets.
Depuis 2008, je suis passé de l'administration système à la direction de projet. Depuis 2020, je transmets sur ce site des méthodes nées du terrain, à travers des articles, des livres, des outils et des formations.
Certifications


À lire ensuite
 Transformation ITGestion des changements ITIL : CAB, demande de changement, types13 min de lecture
 Transformation ITGestion des incidents ITIL : priorité, incident majeur, escalade13 min de lecture
 Transformation ITTransition des services ITIL : changements, mises en production, configurations13 min de lecture