Exploitation des services ITIL : les 5 processus et les 4 fonctions
Sommaire 10 parties
- Qu’est-ce que l’exploitation des services ITIL ?
- Les 5 processus de l’exploitation des services
- Incident, problème, demande : le parcours d’une panne
- Les 4 fonctions de l’exploitation
- Les indicateurs d’une exploitation qui fonctionne
- L’exploitation dans ITIL 4 et ITIL 5
- Exploitation et chef de projet : ce que le run attend du build
- Les erreurs fréquentes en exploitation
- Questions fréquentes sur l’exploitation des services ITIL
- Sources
L’exploitation des services ITIL regroupe tout ce qui fait tourner les services informatiques au quotidien : surveiller, rétablir après une panne, répondre aux demandes, supprimer les causes des incidents et gérer les accès. Dans ITIL v3, c’est la quatrième phase du cycle de vie, celle où le service rencontre enfin ses utilisateurs. Elle compte 5 processus et 4 fonctions.
Je dirige un pôle infrastructure IT, et l’exploitation est le cœur de son activité. Ce guide présente ce que dit ITIL, processus par processus, avec le parcours complet d’une panne, l’organisation du support en niveaux, les indicateurs utiles et ce que l’exploitation attend des projets qui lui livrent de nouveaux services.
- L’exploitation des services (Service Operation) est la 4e des 5 phases du cycle de vie ITIL v3, entre la transition et l’amélioration continue.
- Elle compte 5 processus : gestion des événements, gestion des incidents, exécution des requêtes, gestion des problèmes et gestion des accès.
- Elle décrit 4 fonctions, c’est-à-dire des équipes : le centre de services, la gestion technique, la gestion des applications et la gestion des opérations IT.
- L’incident rétablit le service. Le problème supprime la cause. Les confondre fait revenir les mêmes pannes.
- Dans ITIL 4, processus et fonctions deviennent des pratiques. Dans ITIL 5, l’exploitation correspond aux étapes exploiter, fournir et soutenir.
Qu’est-ce que l’exploitation des services ITIL ?
L’exploitation des services fournit aux utilisateurs les services convenus, au niveau convenu. Elle gère au jour le jour les applications, l’infrastructure et les équipes qui les supportent. C’est la phase la plus visible de la DSI : quand elle fonctionne, personne ne la remarque, et quand elle échoue, tout le monde le sait.
Sa place dans le cycle de vie ITIL v3
Le cycle de vie ITIL v3 compte 5 phases, présentées dans le guide ITIL : stratégie, conception, transition, exploitation et amélioration continue. L’exploitation reçoit de la transition un service testé et mis en production, avec sa documentation. Elle renvoie à l’amélioration continue ce qu’elle mesure et ce qu’elle constate : incidents récurrents, engagements non tenus, demandes trop lentes.
C’est aussi la phase la plus longue. Un projet dure quelques mois, un service tourne pendant des années. La qualité de la conception des services se paie ou se rembourse ici, chaque jour.
Ses objectifs
- Fournir les services au niveau promis dans les engagements de service.
- Rétablir le service le plus vite possible quand il est interrompu.
- Réduire le nombre et l’impact des pannes, en traitant leurs causes.
- Traiter les demandes courantes des utilisateurs de façon fiable et rapide.
- Protéger l’accès aux services et aux données.
Les 4 équilibres à tenir
Le livre ITIL consacré à l’exploitation insiste sur une idée souvent oubliée : exploiter, c’est arbitrer en permanence entre des exigences opposées. Il décrit quatre équilibres.
| Équilibre | Le risque d’un côté | Le risque de l’autre |
|---|---|---|
| Vue interne IT et vue externe métier | Des serveurs bien gérés, mais des utilisateurs mécontents | Des promesses faites au métier que la technique ne peut pas tenir |
| Stabilité et réactivité | Un système si figé que chaque évolution prend des mois | Des changements si rapides que la production devient instable |
| Qualité de service et coût | Un service irréprochable mais hors de prix | Des économies payées en pannes et en lenteurs |
| Réactif et proactif | Une équipe qui court d’incident en incident | Des projets d’amélioration pendant que le quotidien n’est pas tenu |
Il n’y a pas de bon réglage universel. Une DSI qui sort d’une période de pannes doit d’abord stabiliser. Une DSI stable mais lente doit gagner en réactivité. L’important est de savoir de quel côté on penche, et pourquoi.
Les 5 processus de l’exploitation des services
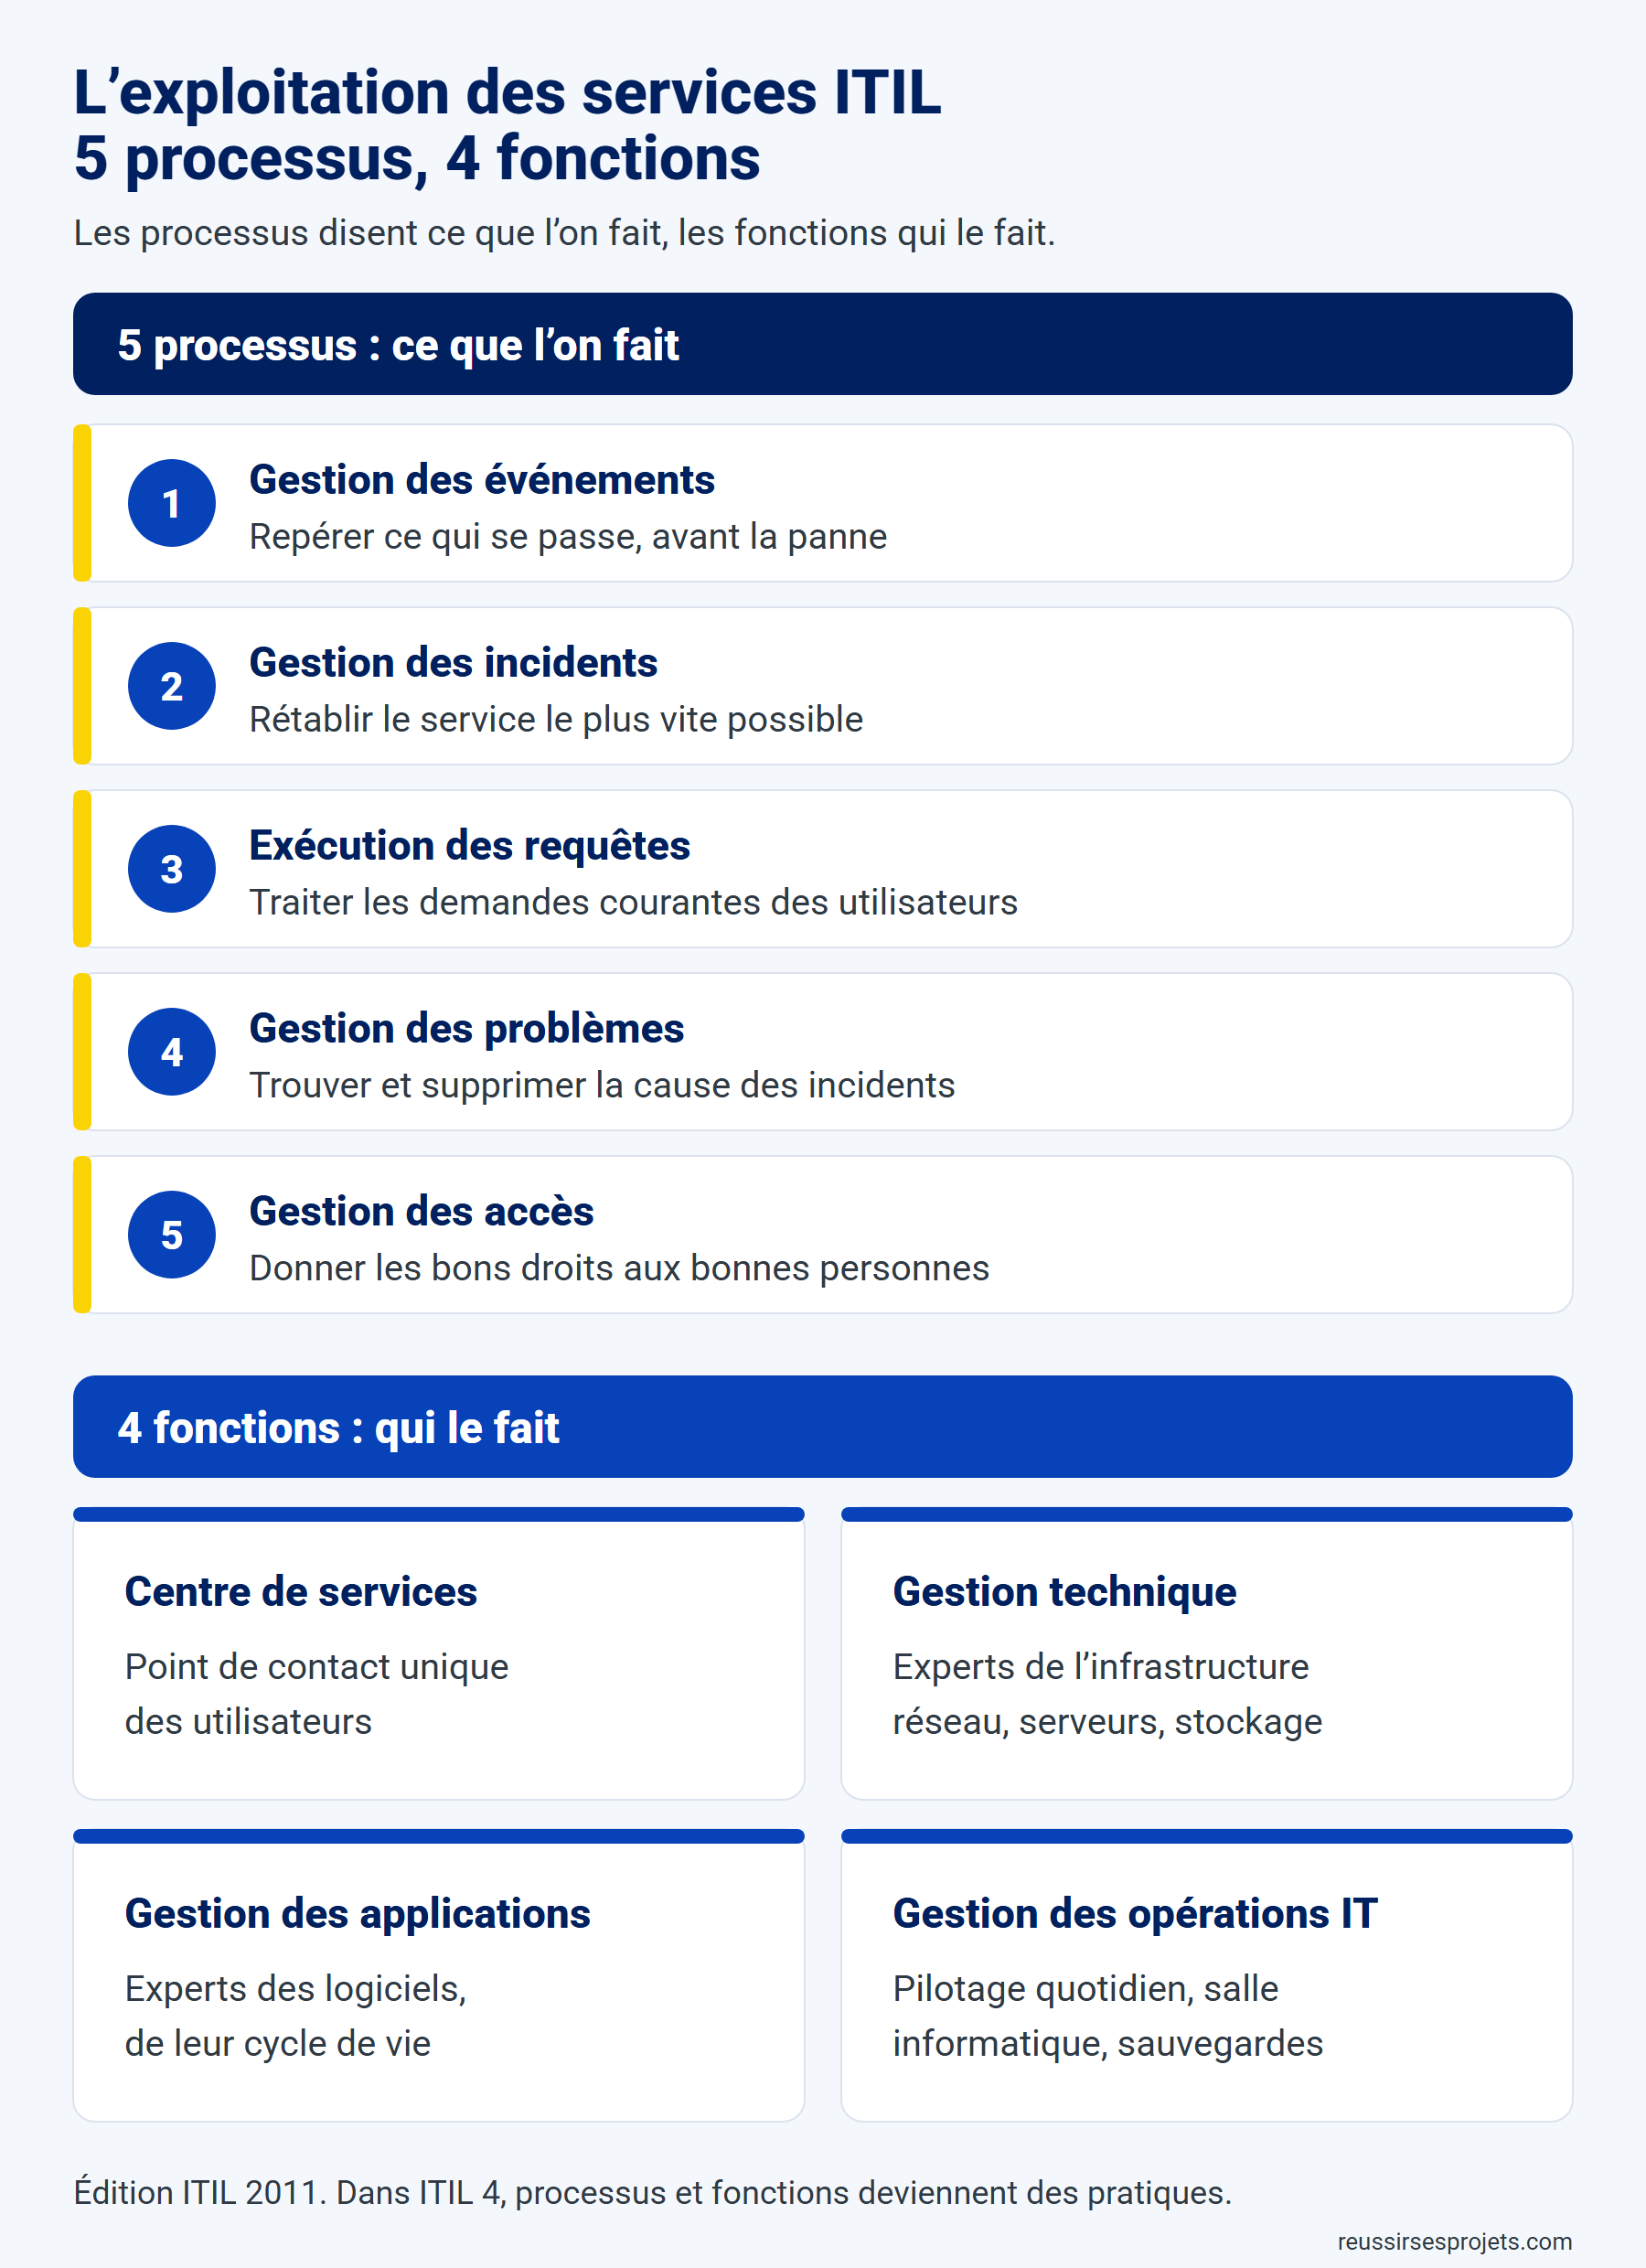
Les processus décrivent ce que l’on fait. Les fonctions, présentées plus bas, décrivent qui le fait. Le schéma ci-dessous rassemble les deux.
| Processus | Objectif | Déclencheur typique |
|---|---|---|
| Gestion des événements | Détecter et trier ce qui se passe sur l’infrastructure et les applications | Une alerte de supervision |
| Gestion des incidents | Rétablir le service le plus vite possible | Un appel, un ticket, une alerte critique |
| Exécution des requêtes | Traiter les demandes de service des utilisateurs | Une demande dans le catalogue |
| Gestion des problèmes | Trouver la cause des incidents et la supprimer | Un incident majeur ou des incidents répétés |
| Gestion des accès | Accorder les droits prévus, et seulement ceux-là | Une arrivée, un départ, un changement de poste |
1. Gestion des événements
Un événement est un changement d’état qui compte pour la gestion d’un service : un serveur qui redémarre, un disque qui se remplit, une sauvegarde qui échoue. La gestion des événements reçoit les signaux de la supervision, les filtre et décide quoi en faire. Chaque organisation choisit ses catégories, mais ITIL en recommande au moins trois :
- informatif : tout va bien, on le note (une sauvegarde terminée)
- avertissement : un seuil approche, il faut agir avant la panne (disque plein à 80 %)
- exception : quelque chose ne fonctionne pas normalement. Cela ouvre souvent un incident, mais pas toujours.
2. Gestion des incidents
Un incident est une interruption non planifiée d’un service, ou une baisse de sa qualité. Une panne qui n’a pas encore touché les utilisateurs, comme la perte d’un disque dans un serveur redondé, est aussi un incident. L’objectif est simple : rétablir le service au plus vite, même provisoirement, sans forcément comprendre la cause.
Chaque incident reçoit une priorité, qui croise son impact (combien d’utilisateurs ou quel enjeu métier) et son urgence (à quelle vitesse il faut agir). Voici un exemple de matrice, à adapter à vos engagements :
| Urgence \ Impact | Impact élevé | Impact moyen | Impact faible |
|---|---|---|---|
| Urgence haute | P1 critique | P2 haute | P3 moyenne |
| Urgence moyenne | P2 haute | P3 moyenne | P4 basse |
| Urgence basse | P3 moyenne | P4 basse | P5 planifiée |
Les incidents les plus graves suivent une procédure à part, celle de l’incident majeur : un responsable désigné, une cellule dédiée, une communication régulière aux utilisateurs et une revue après coup. Cette revue ressemble à un retour d’expérience projet : comprendre, sans chercher de coupable, et décider ce qui change.
3. Exécution des requêtes
Une demande de service n’est pas une panne. C’est une demande courante, prévue et souvent préautorisée : un nouveau poste, un accès à une application, un mot de passe à réinitialiser, une information. Les traiter comme des incidents fausse les statistiques et encombre les techniciens.
L’exécution des requêtes s’appuie sur le catalogue des services et sur des modèles de demande : pour chaque type de demande, on sait qui valide, qui réalise, en combien de temps. Plus une demande est fréquente, plus elle mérite d’être standardisée, voire automatisée.
4. Gestion des problèmes
Un problème est la cause, connue ou non, d’un ou plusieurs incidents. Là où la gestion des incidents rétablit, la gestion des problèmes cherche pourquoi et supprime la cause. Elle travaille de deux façons :
- de façon réactive, après un incident majeur ou une série d’incidents identiques
- de façon proactive, en analysant les incidents et leurs tendances pour repérer les pannes avant qu’elles ne se produisent, souvent en lien avec l’amélioration continue.
Un incident ne « devient » jamais un problème : les deux sont enregistrés à part, puis reliés. Deux autres notions reviennent sans cesse. Une solution de contournement réduit ou supprime l’effet d’un incident sans traiter sa cause. Une erreur connue est un problème dont la cause et une solution de contournement sont documentées. Les erreurs connues sont rassemblées dans une base, la KEDB (Known Error Database), que le centre de services consulte pour résoudre plus vite.
Pour trouver la cause, des techniques simples suffisent souvent, comme la méthode des 5 pourquoi. La correction définitive passe ensuite par la gestion des changements, en transition des services.
5. Gestion des accès
La gestion des accès accorde aux utilisateurs autorisés le droit d’utiliser un service, et le refuse aux autres. Elle applique les règles fixées par la gestion de la sécurité de l’information : elle ne décide pas qui a droit à quoi, elle exécute. Ses moments clés sont l’arrivée d’un salarié, son changement de poste et, surtout, son départ. Un compte resté actif après un départ est l’un des écarts les plus fréquents en audit.
Incident, problème, demande : le parcours d’une panne
Les processus de l’exploitation s’enchaînent. Le plus simple pour le comprendre est de suivre une panne réelle, de l’alerte à la correction définitive.
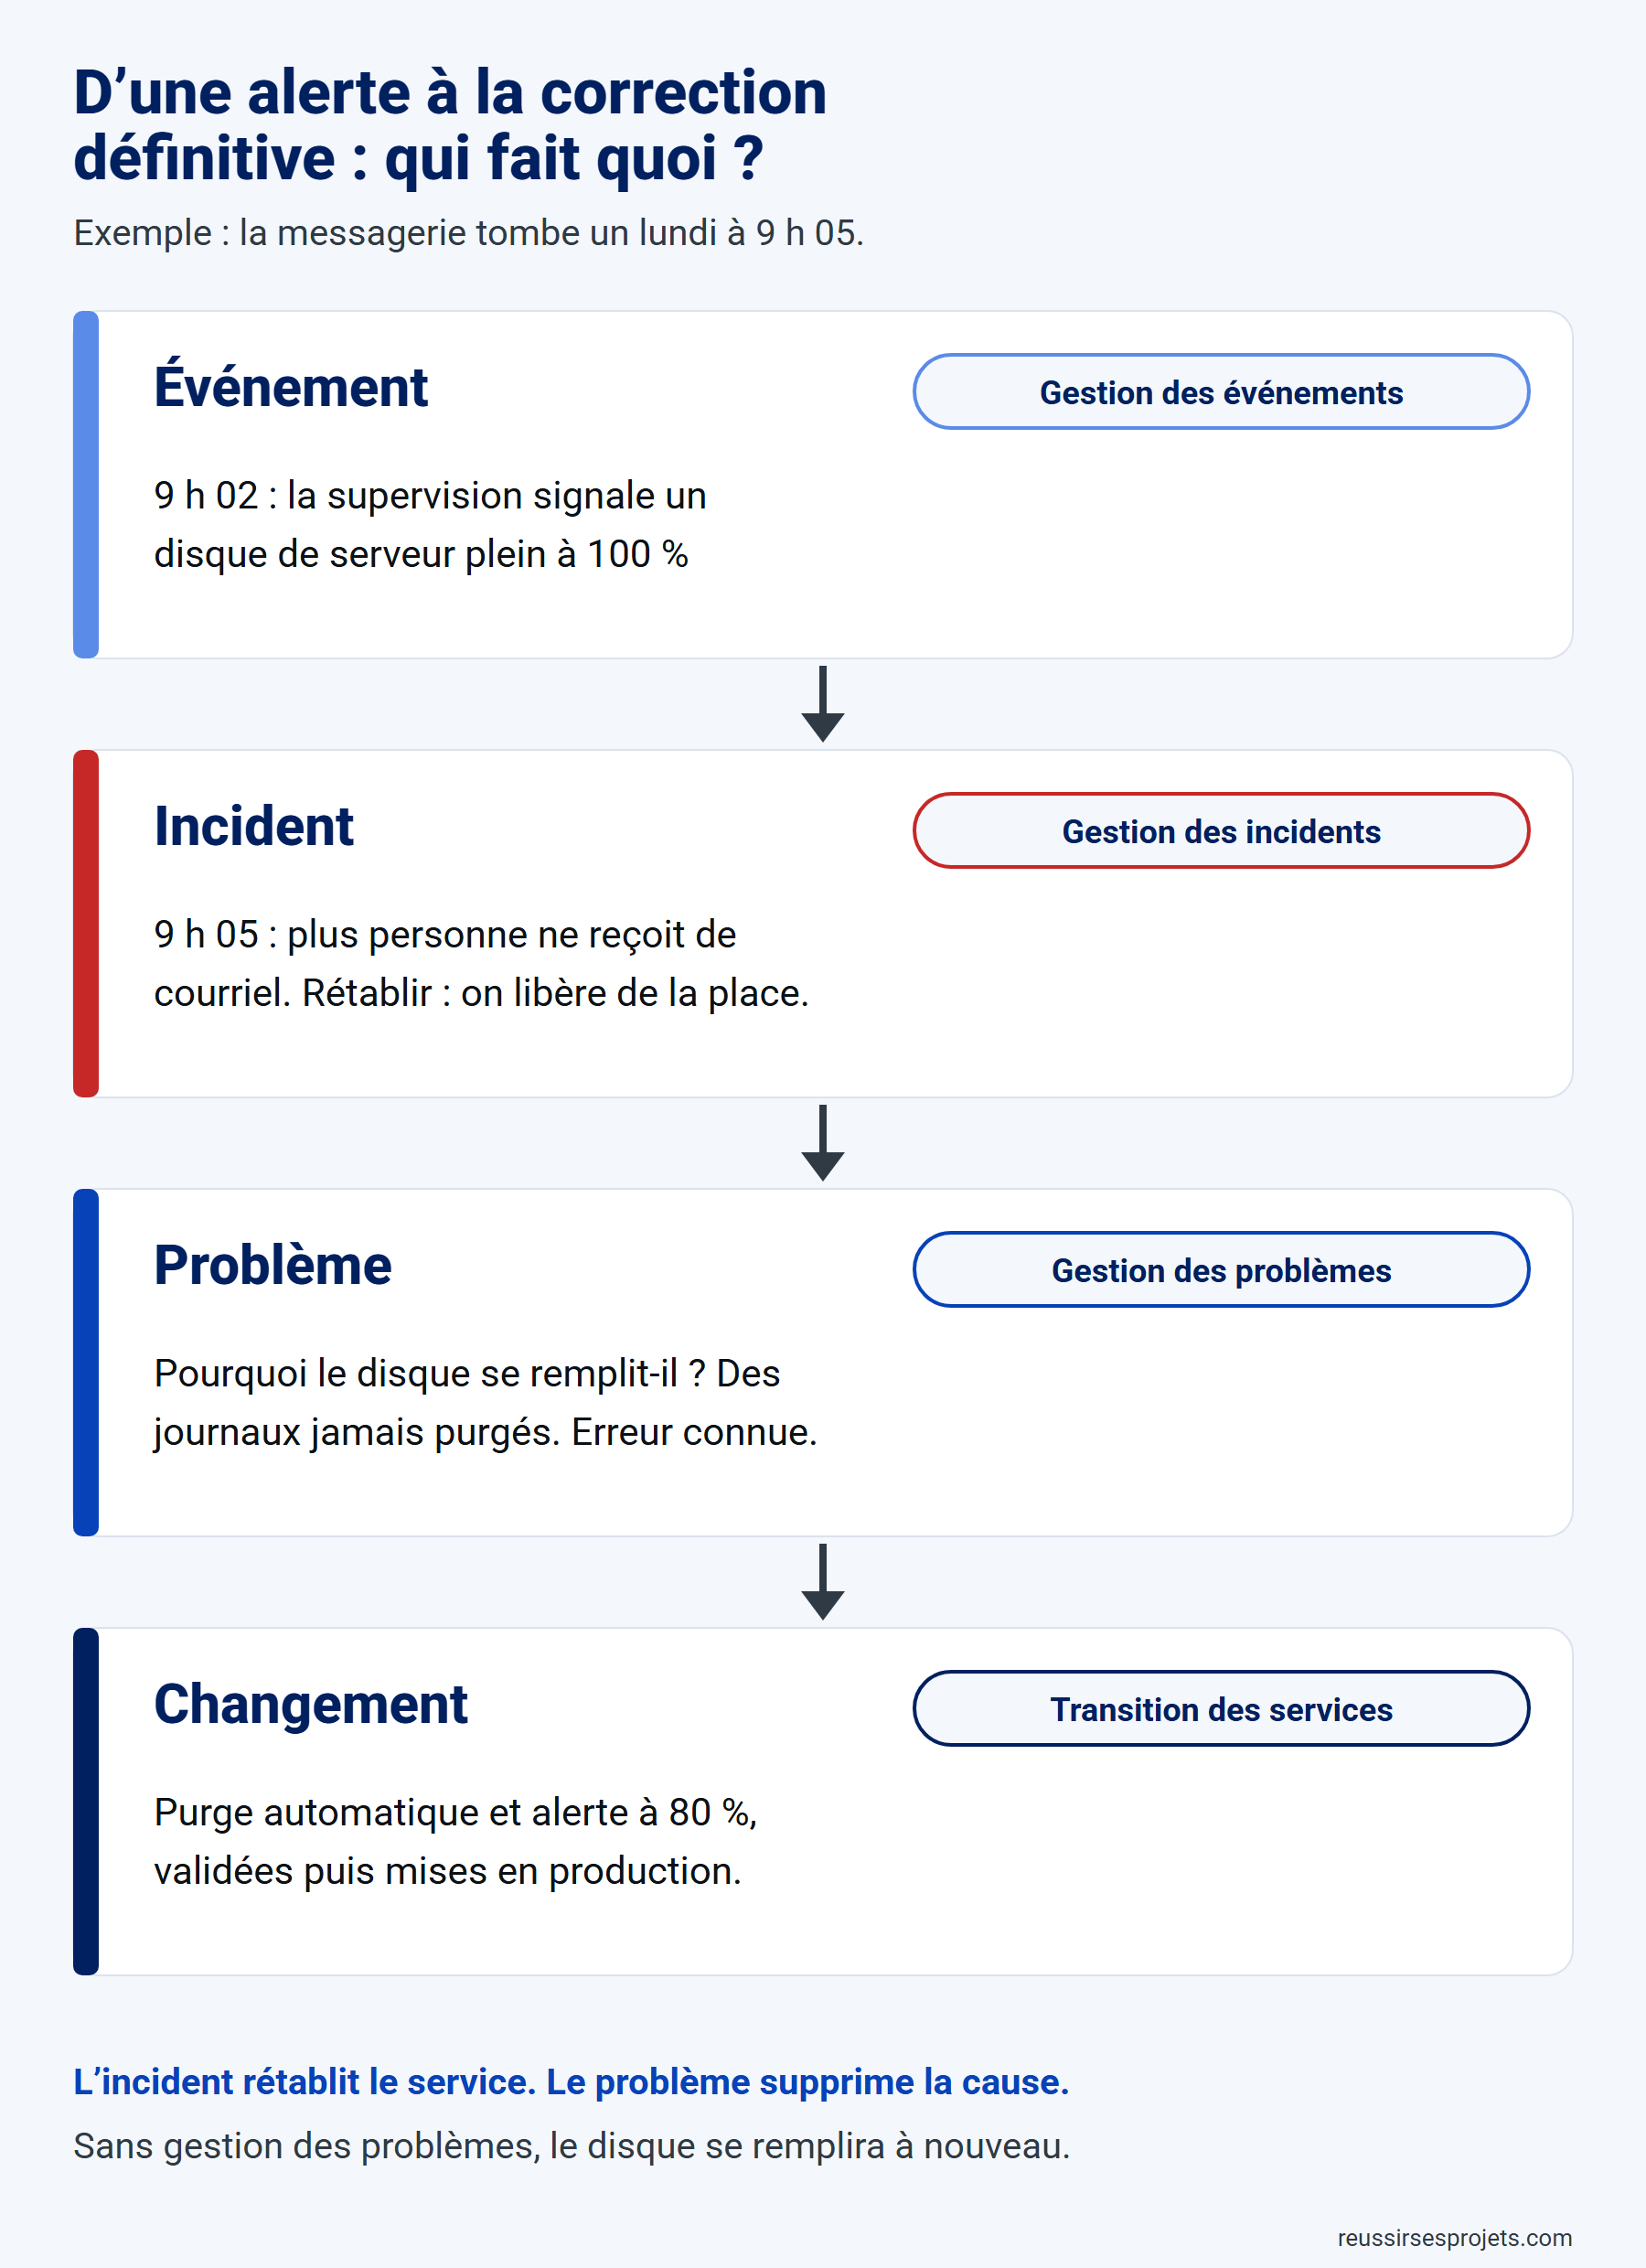
Dans cet exemple, la gestion des incidents a fait son travail en quelques minutes : la messagerie refonctionne. Mais si l’on s’arrête là, le disque se remplira à nouveau dans trois semaines. C’est la gestion des problèmes qui trouve la cause et déclenche la correction, mise en production comme un changement.
| Notion | Question | Objectif | Exemple |
|---|---|---|---|
| Événement | Que se passe-t-il ? | Détecter | Disque plein à 80 % |
| Incident | Qu’est-ce qui ne marche plus ? | Rétablir vite | La messagerie ne répond plus |
| Problème | Pourquoi cela arrive-t-il ? | Supprimer la cause | Des journaux jamais purgés |
| Demande de service | De quoi l’utilisateur a-t-il besoin ? | Fournir un élément prévu | Un accès à une boîte partagée |
| Changement | Que modifie-t-on ? | Modifier sans casser | La purge automatique des journaux |
Le mot « problème » n’a pas le même sens en gestion de projet. Pour un chef de projet, c’est un risque qui s’est réalisé. Voir à ce sujet l’imprévu, l’aléa, le risque et le problème.
Les 4 fonctions de l’exploitation
Une fonction, dans ITIL v3, est une équipe ou un groupe de personnes, avec les outils qu’elles utilisent. L’exploitation en décrit quatre.
| Fonction | Rôle | Exemples d’équipes |
|---|---|---|
| Centre de services | Point de contact unique entre la DSI et les utilisateurs | Support, hotline, service desk |
| Gestion technique | Expertise et gestion de l’infrastructure | Réseau, systèmes, stockage, sécurité |
| Gestion des applications | Expertise et gestion des applications tout au long de leur vie | Équipes applicatives, intégrateurs |
| Gestion des opérations IT | Activités quotidiennes de production | Pilotage, sauvegardes, salle informatique |
Le centre de services
Le centre de services reçoit les appels, les courriels et les tickets. Il enregistre tout, résout ce qu’il peut et transmet le reste. Il informe aussi les utilisateurs pendant les incidents. Sa qualité se mesure d’abord à sa capacité à résoudre dès le premier contact.
ITIL décrit plusieurs façons de l’organiser : un centre de services local, près des utilisateurs, un centre centralisé pour toute l’organisation, un centre virtuel dont les équipes sont réparties mais travaillent comme une seule, ou le modèle follow the sun, où des centres situés sur plusieurs fuseaux horaires se passent le relais pour couvrir 24 heures sur 24.
Le support s’organise en niveaux. ITIL parle de support de premier, deuxième et troisième niveau (first-line, second-line, third-line support). En France, on dit plus souvent N1, N2 et N3 :
| Niveau | Qui | Ce qu’il traite |
|---|---|---|
| N1 | Centre de services | Prise en charge, diagnostic simple, solutions connues, demandes standards |
| N2 | Équipes techniques ou applicatives | Diagnostic approfondi, interventions sur les systèmes |
| N3 | Experts, éditeurs, constructeurs | Cas complexes, anomalies logicielles, corrections |
Quand un ticket passe d’un niveau à l’autre, on parle d’escalade fonctionnelle : on le confie à plus d’expertise. L’escalade hiérarchique est différente : on informe ou on mobilise la hiérarchie, parce que l’incident est grave ou que le délai promis risque d’être dépassé. Les deux peuvent avoir lieu en même temps.
La gestion technique
Elle regroupe les experts de l’infrastructure : réseau, serveurs, stockage, bases de données, sécurité. Elle conçoit, maintient et fait évoluer les plateformes, et elle fournit le niveau 2 ou 3 du support. Elle participe aussi à la conception des nouveaux services, pour qu’ils soient exploitables.
La gestion des applications
Elle gère les applications sur toute leur durée de vie, du choix ou du développement jusqu’au retrait. Il ne faut pas la confondre avec le développement : elle porte l’expertise applicative en production, les montées de version et le support avancé.
La gestion des opérations IT
Elle exécute les activités quotidiennes : pilotage de la production, traitements planifiés, sauvegardes et restaurations, impressions de masse, gestion de la salle informatique et de ses installations. ITIL la découpe en deux parties : le contrôle des opérations et la gestion des installations.
Les indicateurs d’une exploitation qui fonctionne
Quelques indicateurs bien choisis suffisent à piloter une exploitation :
| Indicateur | Ce qu’il montre |
|---|---|
| Délai de rétablissement des incidents P1 et P2 | La capacité à limiter l’impact des pannes graves |
| Taux de résolution au premier contact | L’efficacité du centre de services et de sa base de connaissance |
| Nombre d’incidents récurrents sans problème ouvert | Les causes que personne ne traite |
| Respect des délais des demandes de service | La fiabilité du quotidien vue par les utilisateurs |
| Satisfaction après résolution | La perception réelle, au-delà des chiffres |
L’exploitation dans ITIL 4 et ITIL 5
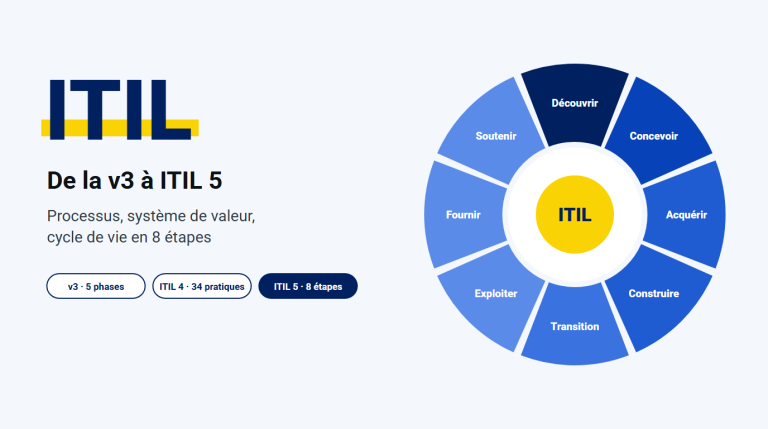
ITIL 4 a abandonné les phases, les processus et les fonctions au profit de 34 pratiques. Le contenu de l’exploitation n’a pas disparu : il s’est réparti entre plusieurs pratiques. Dans la chaîne de valeur d’ITIL 4, il correspond surtout à l’activité « fournir et soutenir », qui garantit que les services sont fournis et soutenus comme convenu.
| ITIL v3 (exploitation) | Pratique ITIL 4 | Famille dans ITIL 4 |
|---|---|---|
| Gestion des événements | Surveillance et gestion des événements | Gestion des services |
| Gestion des incidents | Gestion des incidents | Gestion des services |
| Exécution des requêtes | Gestion des demandes de service | Gestion des services |
| Gestion des problèmes | Gestion des problèmes | Gestion des services |
| Gestion des accès | Pas de pratique dédiée | Voir la gestion de la sécurité de l’information (gestion générale) |
| Centre de services (fonction) | Centre de services | Gestion des services |
| Gestion technique (fonction) | Gestion des infrastructures et des plateformes | Gestion technique |
| Gestion des applications (fonction) | Développement et gestion des logiciels | Gestion technique |
Pour les accès, ITIL 4 n’a plus de pratique propre. Dans les faits, une demande d’accès passe par la gestion des demandes de service et suit les règles de la sécurité de l’information.
ITIL 5, publié en 2026, décrit un cycle de vie des produits et services en 8 étapes : découvrir, concevoir, acquérir, construire, effectuer la transition, exploiter, fournir et soutenir. ITIL ne publie pas de correspondance officielle, mais les trois dernières couvrent l’essentiel de ce que la v3 appelait l’exploitation. Le vocabulaire change, le quotidien du centre de services et des équipes techniques reste le même.
Exploitation et chef de projet : ce que le run attend du build
Un projet livre un service à l’exploitation, qui le fera vivre pendant des années. La transition du build vers le run se passe bien quand l’exploitation reçoit, avant la mise en production :
- la supervision configurée, avec des seuils d’alerte utiles
- le dossier d’exploitation : architecture, procédures de démarrage et d’arrêt, sauvegardes, reprise
- les modèles de demande dans le catalogue, avec leurs circuits de validation
- les articles de connaissance pour le N1, avec les solutions aux questions prévisibles
- les erreurs connues au moment de la mise en production, et leurs contournements
- les contacts de support des fournisseurs et leurs délais d’intervention
- une période de garantie pendant laquelle l’équipe projet reste mobilisée sur les incidents.
Ces éléments se préparent dès la conception, et se planifient comme le reste du projet. Les oublier fait partie des risques les plus courants d’un projet IT : le service fonctionne le jour J, puis le support s’effondre dans les semaines qui suivent.
Les erreurs fréquentes en exploitation
- Tout traiter comme un incident. Les demandes de service noient les vraies pannes et faussent les délais.
- Rétablir sans jamais chercher la cause. Les mêmes incidents reviennent chaque mois, et l’équipe s’épuise.
- Superviser trop, ou pas assez. Trop d’alertes et plus personne ne les lit, pas assez et ce sont les utilisateurs qui préviennent.
- Un centre de services sans base de connaissance. Tout remonte en N2, et les experts passent leurs journées à répondre aux mêmes questions.
- Oublier les départs. Des comptes restent actifs des mois après le départ de leur titulaire.
- Piloter au volume. Le nombre de tickets fermés monte, la satisfaction baisse.
Questions fréquentes sur l’exploitation des services ITIL
Quels sont les 5 processus de l’exploitation des services ITIL ?
La gestion des événements, la gestion des incidents, l’exécution des requêtes, la gestion des problèmes et la gestion des accès.
Quelles sont les 4 fonctions de l’exploitation des services ?
Le centre de services, la gestion technique, la gestion des applications et la gestion des opérations IT. Une fonction est une équipe, alors qu’un processus est un ensemble d’activités.
Quelle différence entre un incident et un problème ?
L’incident est l’interruption ou la dégradation d’un service : on le rétablit au plus vite. Le problème est la cause d’un ou plusieurs incidents : on la cherche puis on la supprime.
Quelle différence entre un incident et une demande de service ?
L’incident est imprévu : quelque chose ne fonctionne plus. La demande de service est prévue : l’utilisateur a besoin d’un élément standard, comme un accès ou un équipement.
Que signifient N1, N2 et N3 ?
Ce sont les niveaux de support. Le N1 est le centre de services, qui prend en charge et résout les cas simples. Le N2 regroupe les équipes techniques ou applicatives. Le N3 rassemble les experts, éditeurs et constructeurs.
Quelle différence entre centre de services, help desk et call center ?
Le call center prend les appels et les oriente. Le help desk gère les incidents et cherche à les résoudre. Le centre de services va plus loin : point de contact unique de la DSI, il traite aussi les demandes de service, informe les utilisateurs et alimente la base de connaissance.
L’exploitation des services existe-t-elle encore dans ITIL 4 ?
Pas comme une phase. Ses processus et fonctions sont devenus des pratiques, comme la gestion des incidents, la gestion des problèmes ou le centre de services. Dans la chaîne de valeur, ils correspondent surtout à l’activité « fournir et soutenir ».
Sources
- Glossaire officiel ITIL 2011, entrées service operation, incident, problem, known error, workaround, event, service request, access management, service desk et first-line support (Crown Copyright 2011).
- ITIL Service Operation, édition 2007 : équilibres de l’exploitation (section 3.2), processus (sections 4.1 à 4.5), organisation du centre de services (section 6.2).
- Pink Elephant, processus des éditions ITIL 2007 et 2011.
- AXELOS, Introductory Overview of ITIL 4 (2020) : répartition des 34 pratiques et chaîne de valeur.
- ITIL.com, ITIL Foundation (Version 5) : les nouveautés : cycle de vie en 8 étapes.

Thibault Baheux
Expert en pilotage de projets IT & transformations complexes
Responsable de pôle infrastructure IT, auteur et fondateur de Réussir Ses Projets, je manage 15 personnes en direct et je pilote un portefeuille de projets.
Depuis 2008, je suis passé de l'administration système à la direction de projet. Depuis 2020, je transmets sur ce site des méthodes nées du terrain, à travers des articles, des livres, des outils et des formations.
Certifications